Archivierung klinischer Studiendaten – Teil 5/5
Teil 1 dieser Reihe behandelte die Umwandlung von Kostenstellen in strategische Vermögenswerte. Teil 2 befasste sich mit der Umwandlung von Daten aus der Rückspiegelanalyse in Trainingsdaten für KI. Teil 3 zeigte, wie der Archivierungsaufwand aus Fusionen und Übernahmen zu einem Wettbewerbsvorteil werden kann. Teil 4 behandelte die Überwindung von Anwendungssilos hin zu echter Interoperabilität. Dieser Beitrag widmet sich der fünften und letzten Dimension: Was geschieht, wenn jemand tatsächlich schnell auf die Daten einer kompletten Studie zugreifen muss, um eine schwierige Frage zu beantworten?
Anfang des Jahres forderte die FDA die Arzneimittelhersteller auf, den Warnhinweis zu Suizidgedanken von drei GLP-1-Präparaten zur Gewichtsreduktion – Saxenda, Wegovy und Zepbound – zu entfernen. Dieser Aufforderung ging eine Überprüfung voraus, die im Juli 2023 begann, nachdem die Behörde erste Berichte über einen möglichen Zusammenhang erhalten hatte. Die abschließende Analyse umfasste 91 placebokontrollierte Studien mit 107,910 Patienten sowie eine separate Real-World-Studie mit über 2.2 Millionen Patienten. Das Ergebnis: kein erhöhtes Risiko. Der Warnhinweis wurde entfernt.
Liest man zwischen den Zeilen, liegt die eigentliche Geschichte nicht im Ergebnis selbst, sondern im Weg dorthin. Einige der 91 Studien reichen bis in die Mitte der 2000er-Jahre zurück, wurden nach unterschiedlichen Protokollen und von verschiedenen Teams durchgeführt – lange bevor diese spezifische Frage überhaupt gestellt wurde. Um sie zu beantworten, mussten patientenbezogene Daten aus jeder einzelnen Studie zusammengetragen und in einem Datensatz zusammengeführt werden. Das ist keine einfache Suche, sondern ein Datenabfrageproblem auf Ebene der gesamten Studie, nicht nur eines einzelnen Feldes oder Formulars.
Die meisten klinischen Datenrecherchen sind dafür noch nicht ausgelegt. Sie erfolgen auf Anwendungsebene: Man meldet sich im EDC an, um eine Sache zu überprüfen, im eTMF für eine andere und in einer Sicherheitsdatenbank für eine dritte. Jede einzelne Suche ist schnell, aber die Zusammenführung all dieser Daten zu einem vollständigen, verlässlichen Studiendatensatz ist der zeitaufwändigste Prozess.
Dieser Zeitverlust hat seinen Preis, und zwar einen beträchtlichen. Eine vielzitierte ökonomische Analyse der biomedizinischen Forschung bezifferte die jährlichen Kosten nicht reproduzierbarer präklinischer Forschung in den USA auf rund 28 Milliarden US-Dollar. Ein Großteil dieser Daten ließ sich weder verifizieren noch rekonstruieren. Klinische Studien werden zwar strenger durchgeführt als präklinische Untersuchungen, doch das zugrundeliegende Problem bleibt bestehen: Technisch gespeicherte Daten sind nicht dasselbe wie tatsächlich abrufbare, vollständige und für eine erneute Analyse geeignete Daten.
Für diese Art von „abrufbaren“ Daten gibt es einen Namen: das Analyseergebnisdatenmodell (ARDM) . Anstatt sich mit Rohdaten zufriedenzugeben, behandelt es die Analyseergebnisse selbst: die Tabellen, Statistiken und Grafiken einer Studie als strukturierte, maschinenlesbare und wiederverwendbare Daten – nicht als statisches PDF, das niemand abfragen kann. Der Grundgedanke lautet: „ Einmal schreiben, immer wieder verwenden “: Ein für einen Zweck berechnetes Ergebnis bleibt für den nächsten Zweck abrufbar, anstatt in einem Dokument eingeschlossen und jedes Mal neu berechnet zu werden.
Die folgenden vier Beispiele machen deutlich, dass die Abruflücke nicht einfach als ein einziger misslungener Versuch abgetan werden kann.
Eine Studie aus dem Jahr 2026 : Ein Team reproduzierte die Ergebnisse einer bereits veröffentlichten klinischen Studie. Die Arbeit umfasste mehrere hundert Arbeitsstunden, verteilt auf fünf separate Teams: Das ursprüngliche Datenwörterbuch war nicht auffindbar, und die statistischen Startwerte, die zur Reproduktion der Ergebnisse benötigt wurden, waren nicht dokumentiert. Nicht etwa, weil die Daten nicht existierten, sondern weil der Link zum Studienprotokoll unterbrochen war. Fazit der Studie: Ohne das vollständige Studienpaket, das Protokoll, Datenwörterbuch und Methoden umfasst, ist eine Wiederverwendung kaum möglich.
Replikationsstudie in der Praxis , 2019. Forscher versuchten, 220 in hochrangigen Fachzeitschriften veröffentlichte US-amerikanische klinische Studien anhand von Daten aus der Praxis (elektronische Patientenakten und Versicherungsabrechnungen) zu replizieren. Nur 33 Studien (15 %) konnten repliziert werden. Die meisten Fehlschläge ließen sich auf dieselbe Ursache zurückführen, die in dieser Reihe immer wieder hervorgehoben wird: Die Intervention, die Einschlusskriterien oder der Endpunkt waren nicht in strukturierter, außerhalb der Systeme der Originalstudie abrufbarer Form erfasst worden.
Intensivmedizin, 2018. Eine Übersichtsarbeit zu 158 klinischen Verfahren aus intensivmedizinischen Studien ergab, dass nur bei 66 davon (42 %) ein Reproduktionsversuch unternommen wurde. Bei 56 % dieser Versuche stimmten die Ergebnisse nicht mit der Originalstudie überein. Zwei ursprünglich als sicher und wirksam eingestufte Verfahren erwiesen sich nach erneuter Prüfung als schädlich; die Flüssigkeitstherapie mit Hydroxyethylstärke zeigte die deutlichsten Hinweise auf Schäden. Im Durchschnitt vergingen 4.6 Jahre, bis überhaupt ein Überprüfungsversuch unternommen wurde.
Systematische Reviews, 2016. Die Suchstrategie selbst war oft nicht reproduzierbar. Eine Auswertung von 272 systematischen Reviews aus 25 Fachzeitschriften ergab, dass nur 13 % eine ausreichend detaillierte Suchstrategie angaben, um sie in allen verwendeten Datenbanken reproduzieren zu können. Suchbegriffe wurden zwar in 91 % der Fälle angegeben, jedoch fehlte meist die Angabe, auf welche Datenbanken sie angewendet wurden und wann die Suche tatsächlich durchgeführt wurde.
Und es geht nicht nur um die Datenabfrage: Die veröffentlichten Ergebnisse können von den ursprünglichen Vorgaben abweichen. Eine separate Überprüfung von Studienregistrierungen ergab eine mediane Diskrepanz von 31 % zwischen registrierten und veröffentlichten primären Endpunkten, die in einigen Studien sogar 100 % erreichte, sowie eine mediane Diskrepanz von 54 % bei sekundären Endpunkten. Wenn sich die Ergebnisse nachträglich änderten, führten sie in etwa der Hälfte der Fälle zu einem statistisch signifikanten Ergebnis.
Deshalb tendieren sowohl die Branche als auch die Regulierungsbehörden zur Datenabfrage auf Studienebene, nicht auf Anwendungsebene. Die EMA verlangt seit Inkrafttreten ihrer Richtlinie 0070 im Jahr 2016 die proaktive Veröffentlichung vollständiger klinischer Studienberichte, nicht nur zusammenfassender Ergebnisse. Zeitschriftenherausgeber fordern über das ICMJE seit 2018 einen Plan zum Datenaustausch für klinische Studien. Gemeinnützige Plattformen wie Vivli existieren speziell, damit Forschende vollständige Studiendaten anfordern können, anstatt verstreute Dokumente aus verschiedenen Systemen. All dies funktioniert nicht, wenn „die Studie“ nur als Datenfragmente in voneinander unabhängigen Anwendungen vorliegt.
Die 5 entscheidenden Anforderungen für den Abruf von Studieninhalten:
- Eine einzige, dauerhafte ID für die gesamte StudieNicht eine ID pro Dokument oder Datensatz, sondern eine ID, die das Protokoll, die Studiendaten, den Analysecode und den klinischen Studienbericht (CSR) zu einer abrufbaren Einheit verbindet.
- Ein Komplettpaket, nicht nur der DatensatzDie 2026 durchgeführte Reanalyse einer einzelnen Studie dient als warnendes Beispiel: Die Rohdaten ohne Protokoll, Datenwörterbuch und Analysemethoden sind nicht wiederverwendbar. Das Datenmodell für Analyseergebnisse (ARDM) verschärft diese Problematik noch.
- Eine einzige gesteuerte Abfrage anstelle von fünf separaten AnmeldungenEin Forscher oder eine Aufsichtsbehörde muss eine ganze Studie in einem Schritt abrufen können, anstatt sie aus dem EDC, eTMF und einem Statistikarchiv zu rekonstruieren.
- Aufgezeichnete Methodik, bis hin zur SaatgutnummerDie exakte Reproduzierbarkeit in dieser Granularität hängt von den Details ab. Was nicht zu diesem Zeitpunkt erfasst wird, kann später nicht wiederhergestellt werden.
- Alte und neue Studien können auf die gleiche Weise abgerufen werden.Für die GLP-1-Überprüfung wurden klinische Studien aus der Mitte der 2000er-Jahre benötigt, um sie mit Studien aus den 2020er-Jahren zusammenzuführen. Ein Abrufsystem, das nur Studien aus dem Vorjahr berücksichtigt, ist eigentlich gar kein Abrufsystem, sondern nur eine vorübergehende Notlösung.
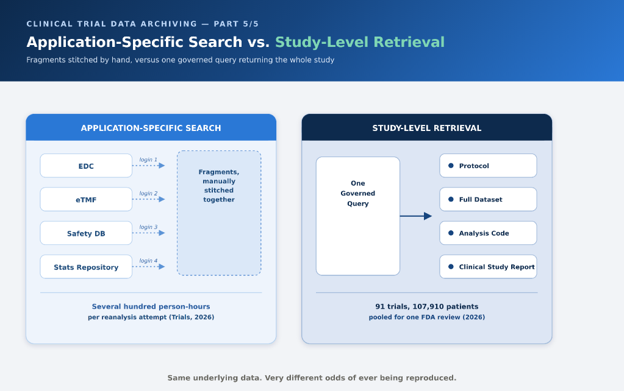
Die Sicherheitsüberprüfung von GLP-1 ist die positive Seite dieser Geschichte. Um die Frage „Besteht tatsächlich ein Suizidrisiko?“ zu beantworten, mussten jahrzehntelange Saxenda-Studien, die lange vor dem Aufkommen dieser Frage durchgeführt wurden, als verfügbare und zusammenführbare Daten zusammen mit neueren Wegovy- und Zepbound-Studien ausgewertet werden. Dies funktioniert nur, wenn die vollständigen Studiendaten als zusammenhängendes, abrufbares Paket vorliegen und nicht nur als Ordner mit Dateien, die zufällig in dem jeweiligen System erhalten geblieben sind. Da dies der Fall war, konnte die Behörde 91 Studien zusammenführen und eine wichtige Sicherheitsfrage anhand realer Daten statt Vermutungen klären: Das Ergebnis war die Aufhebung einer Warnung, nicht eine Verschärfung der Kennzeichnung.
Alle Einträge in dieser Liste entsprechen im Grunde den FAIR-Prinzipien, die in Teil 3 dieser Reihe vorgestellt wurden, angewendet auf die Ebene der Studie anstatt auf die individuelle Akte:
- AuffindbarJede Studie verfügt über eine eindeutige Kennung, nicht über verstreute Dokumenten-IDs in verschiedenen Systemen.
- Für alleEin gesteuerter Abrufprozess liefert die gesamte Studie auf Anfrage, nicht eine manuelle Suche in verschiedenen Systemen.
- InteraktivAlte und neue Studien verwenden eine Struktur, die es ermöglicht, sie in dieselbe gemeinsame Analyse einzubeziehen, ohne dass ein Übersetzungsprojekt erforderlich ist.
- MehrwegProtokoll, Datenwörterbuch, Analysemethoden und Ergebnisse werden gemeinsam weitergegeben, sodass eine erneute Analyse nicht davon abhängt, sich an Details zu erinnern, die niemand notiert hat.
Lässt man auch nur einen dieser Schritte aus, so kehrt die Suche auf Studienebene stillschweigend zu einer anwendungsspezifischen Suche zurück, die zwar technisch möglich, aber praktisch langsam ist und bei der ein defekter Link schnell zu einem nicht reproduzierbaren Ergebnis führen kann.
Damit endet die Blogreihe, daher lohnt es sich, den roten Faden klar zu benennen. Jeder Blogbeitrag behandelte ein anderes Problem: Kostenrechtfertigung, Relevanz von KI, Vorteile von Fusionen und Übernahmen, Anwendungswucherung, Ergebnisse der Datenabfrage . Im Grunde ging es aber immer um dieselbe Frage, nur aus einem anderen Blickwinkel: Sind Ihre Daten so gut verwaltet, dass sie von jemandem gefunden, als vertrauenswürdig eingestuft und wiederverwendet werden können, der bei ihrer Erstellung nicht beteiligt war?
- Dimension 1 - Kostenstelle zu strategischem VermögenswertArchivierte Studiendaten, die sinnvoll wiederverwendet werden, verkürzen die Entwicklungszeiten.
- Dimension 2 - Rückspiegel zu TrainingsdatenDieses Archiv dient als Rohmaterial für KI-Modelle, vorausgesetzt, seine Herkunft wird genauso sorgfältig dokumentiert wie das Modell selbst.
- Dimension 3 - Archivierungslast für Unified AdvantageFusionen und Übernahmen vervielfachen die Datenarchive; die FAIR-Prinzipien sind es, die dafür sorgen, dass die Daten zweier Unternehmen zu einer einzigen nutzbaren Ressource werden, anstatt in zwei Aktenschränken zu landen.
- Dimension 4 - Von Anwendungssilos zu echter Interoperabilität. Spezialisierte Anwendungen können mit echter Interoperabilität koexistieren, aber nur, wenn allen Anwendungen eine gemeinsame, geregelte Datenschicht zugrunde liegt.
- Dimension 5 — Anwendungsspezifische Suche bis hin zum Abruf auf StudienebeneAll das zahlt sich nur dann aus, wenn die gesamte Studie bei Bedarf tatsächlich vollständig und reproduzierbar wiederhergestellt werden kann.
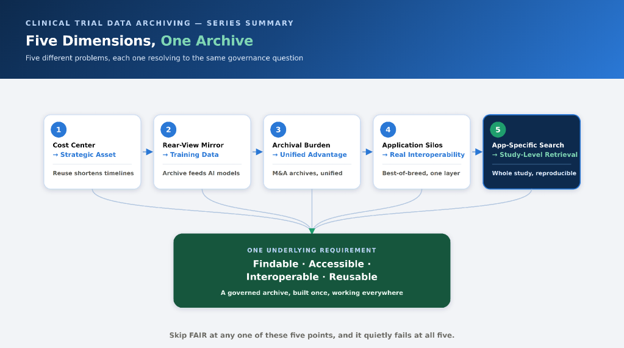
Fünf separate Probleme, eine grundlegende Anforderung: Daten, die auffindbar, zugänglich, interoperabel und wiederverwendbar sind – für KI, für Fusionen und Übernahmen, für die Anwendungen, die sie generieren, und für den Moment, in dem jemand die gesamte Studie reproduzieren muss.
Keine dieser fünf Dimensionen ist für sich genommen optional, und keine funktioniert isoliert. Ein Archiv, das zwar kostengünstig zu erstellen und wiederzuverwenden ist, aber kein KI-Modell speisen, sich nach einer Übernahme nicht vereinheitlichen, in einer heterogenen Anwendungslandschaft nicht bestehen oder unter regulatorischem Druck nicht vollständig wiederhergestellt werden kann, ist nicht wirklich zielführend. FAIR bezog sich nie auf eines dieser fünf Probleme, sondern immer auf alle gleichzeitig.
Wenn Ihre Organisation KI ebenfalls frühzeitig in der Entwicklung von Arzneimitteln einsetzt, um ähnliche Probleme zu lösen, ist das Whitepaper meiner Kollegen Rohit Pardeshi und Soumith Babburi einen Blick wert: Es beschreibt ein Rahmenwerk für die Nutzung vernetzter Dateninfrastrukturen, um KI-gestütztes Drug Repurposing und die Identifizierung von Zielstrukturen zu beschleunigen – dieselbe Logik, die auch in diesem Blog vertreten wird: „Die gesamte Studie im Blick, nicht nur ein einzelnes Forschungsfeld“. Hier geht es darum, zu entscheiden, was als Nächstes erforscht werden soll, anstatt bereits Erforschtes zu verteidigen. Ein Rahmenwerk für KI-gestütztes Drug Repurposing und die Identifizierung von Zielstrukturen in der pharmazeutischen Forschung und Entwicklung.
Wenn Sie in den Bereichen Biostatistik, Zulassungsangelegenheiten oder Datenmanagement tätig sind: Wenn eine Aufsichtsbehörde Ihre Organisation morgen auffordern würde, alle Studien zu einem Produkt der letzten fünfzehn Jahre zusammenzufassen, würden Sie die gesamte Studie abrufen oder sie Antrag für Antrag rekonstruieren?
Häufig gestellte Fragen
Was versteht man unter Studiendatenabruf im Rahmen des klinischen Studiendatenmanagements?
Die Suche nach Studiendaten auf Studienebene ermöglicht den Zugriff auf eine vollständige klinische Studie als einheitliches, verlässliches Paket, anstatt einzelne Datensätze in verschiedenen Anwendungen zu suchen. Dabei werden Studienprotokoll, Studiendaten, Analysemethoden und Studienbericht miteinander verknüpft, sodass die Studie als Ganzes abgerufen und wiederverwendet werden kann.
Worin besteht der Unterschied zwischen anwendungsspezifischer Suche und dem Abruf von Studienergebnissen?
Die anwendungsspezifische Suche ruft Informationen systemweise ab, beispielsweise aus einer EDC-, eTMF- oder Sicherheitsdatenbank. Der Abruf auf Studienebene ermöglicht den Zugriff auf die gesamte Studie mit einer einzigen Anfrage und reduziert so den Aufwand, Informationen manuell aus mehreren voneinander getrennten Systemen zusammenzutragen.
Warum ist der Abruf von Studiendaten für klinische Studien wichtig?
Die Abfrage von Studiendaten erleichtert das Auffinden, den Zugriff, die Analyse, die Reproduktion und die Wiederverwendung klinischer Studiendaten. Die bloße Speicherung der Daten reicht nicht aus; auch das zugehörige Protokoll, das Datenwörterbuch, die Methodik und die Ergebnisse müssen abrufbar und miteinander verknüpft bleiben.
Was sollte in einem vollständigen Datenpaket für eine klinische Studie enthalten sein?
Ein vollständiges klinisches Studienpaket sollte das Studienprotokoll, die Studiendaten, das Datenwörterbuch, den Analysecode bzw. die Analysemethoden sowie den klinischen Studienbericht umfassen. Diese Komponenten liefern den notwendigen Kontext, um die Studie zu verstehen, zu reproduzieren und wiederzuverwenden, anstatt sich allein auf Rohdaten zu stützen.
Was ist das Analyseergebnisdatenmodell (ARDM)?
Das Datenmodell für Analyseergebnisse (ARDM) behandelt Analyseergebnisse wie Tabellen, Statistiken und Abbildungen als strukturierte, maschinenlesbare und wiederverwendbare Daten und nicht als statische Dokumente. Dieser Ansatz ermöglicht es, Analyseergebnisse für die zukünftige Verwendung abzurufen, ohne sie von Grund auf neu berechnen zu müssen.
Wie trägt die Datenabfrage auf Studienebene zur Reproduzierbarkeit klinischer Studien bei?
Die Abfrage von Studiendaten unterstützt die Reproduzierbarkeit, indem alle zur Reproduktion einer Studie benötigten Informationen zusammengehalten werden. Dazu gehören das Studienprotokoll, das Datenwörterbuch, die Analysemethoden und weitere methodische Details, einschließlich exakter Informationen wie statistischer Startwerte, falls erforderlich.
Was sind die fünf wichtigsten Voraussetzungen für das Abrufen von Lerninhalten?
Die fünf kritischen Anforderungen sind eine einzige persistente ID für die gesamte Studie, ein vollständiges Studienpaket, eine gesteuerte Abfrage anstelle mehrerer Anwendungssuchen, eine dokumentierte Methodik und der konsistente Abruf sowohl historischer als auch neuer Studien.
Wie lassen sich die FAIR-Prinzipien auf die Datenbeschaffung in klinischen Studien anwenden?
Die FAIR-Prinzipien gewährleisten, dass Daten klinischer Studien auffindbar, zugänglich, interoperabel und wiederverwendbar sind. Auf Studienebene bedeutet dies die Verwendung persistenter Studienidentifikatoren, kontrollierter Abrufmethoden, kompatibler Strukturen und die Zusammenführung von Protokoll, Daten, Methoden und Ergebnissen.
Wie unterstützt die Auswertung von Studiendaten die regulatorische Überprüfung und Sicherheitsanalyse?
Die Abfrage von Studiendaten ermöglicht es Forschern und Aufsichtsbehörden, vollständige klinische Studiendaten abzurufen und zusammenzuführen, um wichtige Sicherheits- oder Zulassungsfragen zu untersuchen. Die GLP-1-Sicherheitsanalyse veranschaulicht, wie ältere Studien abgerufen und mit neueren Studien kombiniert werden können, um eine spezifische Sicherheitsfrage zu beantworten.
Warum sollten alte klinische Studien mit dem gleichen Verfahren wie neue Studien wiederauffindbar sein?
Für regulatorische Prüfungen, Sicherheitsanalysen oder Forschungszwecke müssen unter Umständen historische Studien mit neueren Studien kombiniert werden. Ein geeignetes Abrufsystem sollte daher sowohl ältere als auch neuere Studien über denselben standardisierten Ansatz zugänglich machen, anstatt den Abruf auf kürzlich erstellte Daten zu beschränken.
Referenzen
- US-amerikanische Arzneimittelbehörde FDA, „FDA fordert Streichung des Warnhinweises zu suizidalem Verhalten und Suizidgedanken bei GLP-1-RA-Medikamenten“ (April 2026) — fda.gov/drugs/drug-safety-communications/fda-requests-removal-suicidal-behavior-and-ideation-warning-glucagon-peptide-1-receptor-agonist-glp
- Science News, „Nicht reproduzierbare Forschung in den Lebenswissenschaften kostet in den USA 28 Milliarden Dollar“, mit Bezug auf Freedman, Cockburn & Simcoe, „Die Ökonomie der Reproduzierbarkeit in der präklinischen Forschung“, PLOS Biology (2015) — sciencenews.org/article/irreproducible-life-sciences-research-us-costs-28-billion
- Kirchner et al., „Überlegungen zu klinischen Studiendaten: Warum wir Analyseergebnisse als Daten respektieren sollten“, Scientific Data (2022) — nature.com/articles/s41597-022-01789-2
- Ansari et al., „Die Reproduzierbarkeit von Suchstrategien ist in systematischen Übersichtsarbeiten, die in hochrangigen Fachzeitschriften für Pädiatrie, Kardiologie und Chirurgie veröffentlicht wurden, schlecht“, PLOS One (2016) — journals.plos.org/plosone/article?id=10.1371/journal.pone.0163309
- Trials (Springer Nature), „Unterstützung der Reanalyse und Wiederverwendung von Daten klinischer Studien: eine Fallstudie“ (2026) — link.springer.com/article/10.1186/s13063-026-09646-y
- Niven et al., „Reproduzierbarkeit klinischer Forschung in der Intensivmedizin: eine Übersichtsarbeit“, BMC Medicine (2018) — link.springer.com/article/10.1186/s12916-018-1018-6
- Franklin et al., „Machbarkeit der Verwendung von Real-World-Daten zur Replikation klinischer Studienergebnisse“, JAMA Network Open (2020) — jamanetwork.com/journals/jamanetworkopen/fullarticle/2752575
- Jones et al., „Vergleich registrierter und veröffentlichter Ergebnisse in randomisierten kontrollierten Studien: eine systematische Übersicht“, BMC Medicine (2015) — link.springer.com/article/10.1186/s12916-015-0520-3
- New England Journal of Medicine, „Transparenz und die Europäische Arzneimittel-Agentur – Weitergabe von Daten aus klinischen Studien“ (2015) — nejm.org/doi/full/10.1056/NEJMp1409464
- Wilkinson et al., „Die FAIR-Leitprinzipien für das Management und die Verwaltung wissenschaftlicher Daten“, Scientific Data (2016) — nature.com/articles/sdata201618
- Vivli, gemeinnützige globale Plattform zum Austausch klinischer Forschungsdaten — vivli.org
#KlinischeStudien #KlinischesDatenmanagement #LifeSciences #Reproduzierbarkeit #FAIRData #Datenstrategie #Arzneimittelentwicklung #Zulassungsangelegenheiten

Murali Krishnam
VP – Produktstrategie, Enterprise Pharma AI
HAFTUNGSAUSSCHLUSS: DIE IN DIESEM BLOG AUSGEDRÜCKTEN INHALTE, ANSICHTEN UND MEINUNGEN STELLEN AUSSCHLIESSLICH DIE DES/DER AUTORS/AUTOREN DAR UND SPIEGELN NICHT DIE OFFIZIELLE RICHTLINIE ODER POSITION VON SOLIX TECHNOLOGIES, INC., SEINEN VERBUNDENEN UNTERNEHMEN ODER PARTNERN WIDER. DIESER BLOG WIRD UNABHÄNGIG BETRIEBEN UND VON SOLIX TECHNOLOGIES, INC. NICHT OFFIZIELL ÜBERPRÜFT ODER UNTERSTÜTZT. ALLE HIER VERWEISTEN MARKEN, LOGOS UND URHEBERRECHTLICH GESCHÜTZTEN MATERIALIEN DRITTER SIND EIGENTUM IHRER JEWEILIGEN EIGENTÜMER. JEGLICHE VERWENDUNG ERFOLGT AUSSCHLIESSLICH ZU IDENTIFIZIERUNGS-, KOMMENTAR- ODER BILDUNGSZWECKEN GEMÄSS DER DOKTRIN DES FAIR USE (US COPYRIGHT ACT § 107 UND INTERNATIONALE ENTSPRECHENDE BESTIMMUNGEN). KEINE STILLSCHWEIGENDE SPONSORING, UNTERSTÜTZUNG ODER VERBINDUNG MIT SOLIX TECHNOLOGIES, INC. IST VORLIEGEND. INHALTE WERDEN „WIE BESEHEN“ BEREITGESTELLT, OHNE GEWÄHRLEISTUNG DER GENAUIGKEIT, VOLLSTÄNDIGKEIT ODER EIGNUNG FÜR EINEN BESTIMMTEN ZWECK. SOLIX TECHNOLOGIES, INC. LEHNT JEGLICHE HAFTUNG FÜR MASSNAHMEN AB, DIE AUF GRUNDLAGE DIESES MATERIALS GETROFFEN WERDEN. DIE LESER ÜBERNEHMEN DIE VOLLE VERANTWORTUNG FÜR IHRE VERWENDUNG DIESER INFORMATIONEN. SOLIX RESPEKTIERT GEISTIGE EIGENTUMSRECHTE. UM EINEN ANTRAG AUF LÖSUNG GEMÄSS DMCA ZU STELLEN, SENDEN SIE EINE E-MAIL AN INFO@SOLIX.COM MIT: (1) DER IDENTIFIZIERUNG DES WERKES, (2) DER URL DES VERLETZENDEN MATERIALS, (3) IHREN KONTAKTDATEN UND (4) EINER ERKLÄRUNG IN GUTEN GLAUBEN. GÜLTIGE ANSPRÜCHE WERDEN UMGEHEND BEARBEITET. DURCH DEN ZUGRIFF AUF DIESEN BLOG ERKLÄREN SIE SICH MIT DIESEM HAFTUNGSAUSSCHLUSS UND UNSEREN NUTZUNGSBEDINGUNGEN EINVERSTANDEN. DIESE VEREINBARUNG UNTERLIEGT DEN GESETZEN KALIFORNIENS.
-
 White Paper (ENG)
Unternehmensinformationsarchitektur für KI und maschinelles Lernen der zweiten Generation
Herunterladen White Paper -
-
-
 White Paper (ENG)
Enterprise Intelligence: Die Grundlage für den Erfolg von KI schaffen
Herunterladen White Paper