Das Gespräch, das die meisten KI-Programme nicht führen
Organisationen, die von einem KI-Pilotprojekt zu einem KI-Programm übergehen, weisen ein gemeinsames Muster auf: Sie lösten die Architekturfrage, bevor sie durch die Skalierung relevant wurde. Sie definierten, wie die Datengrundlage – hinsichtlich Speichereigenschaften, semantischer Schichten und Pipeline-Steuerung – aussehen musste, bevor die zweite oder dritte Produktionsanwendung bereitgestellt wurde.
Die meisten Projekte folgen dieser Vorgehensweise nicht. Das Modell wird ausgewählt, Anwendungsfälle werden definiert, Machbarkeitsstudien erstellt, und die Datengrundlage wird als etwas betrachtet, das sich mit dem Wachstum des Programms befasst. In Unternehmensumgebungen ist diese Annahme regelmäßig die Ursache für Verzögerungen – und Kosten –, wenn schließlich eine Skalierung angestrebt wird.
Zugänglich ist nicht dasselbe wie KI-fähig
Die Unterscheidung, die bei der frühen Planung von KI-Programmen oft übersehen wird, ist die zwischen zugänglichen Daten und Daten, die für die KI geeignet sind.
Zugängliche Daten können abgefragt werden . Sie existieren in einem System, können extrahiert und einem Modell zugeordnet werden. Die meisten Unternehmensdaten erfüllen diese Voraussetzung. KI-fähige Daten werden ab dem Zeitpunkt ihrer Erfassung verwaltet, tragen eine verifizierte semantische Bedeutung, wurden vor der Modellierung qualitätsgeprüft und lassen sich lückenlos von der Quelle bis zum Ergebnis zurückverfolgen.
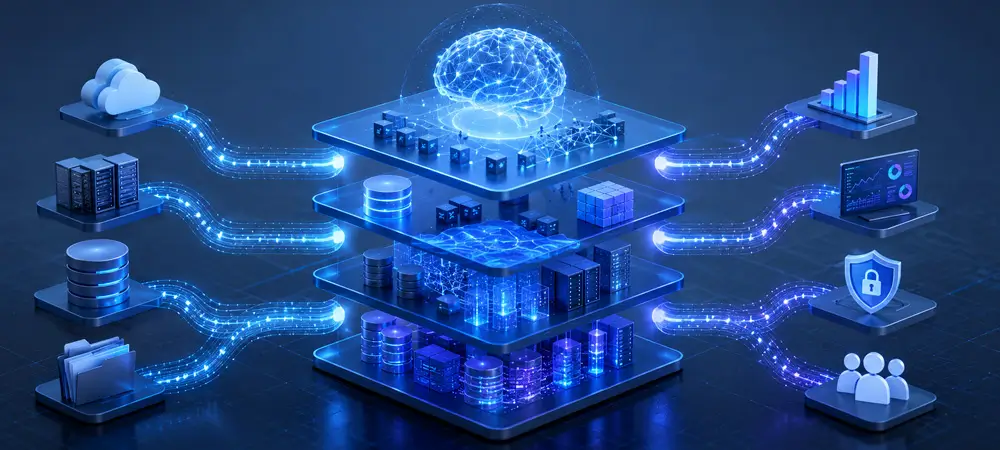
Der Unterschied zwischen diesen beiden Definitionen liegt in der Architektur – nicht im Bereich der Datenqualität. Daten lassen sich in dem Umfang, den KI-Systeme im Unternehmen erfordern, nicht rückwirkend verwalten. Die drei Ebenen, die die Skalierbarkeit von KI-Systemen bestimmen – Speicher, Metadaten und Pipelines – haben jeweils eine spezifische Aufgabe und schaffen die Voraussetzungen für die jeweils nächste Ebene.
Warum das Fundament immer als Letztes gebaut wird
Die meisten Datenumgebungen in Unternehmen wurden nicht für KI konzipiert. Daten landen in Speichersystemen, die für die Transaktionsverarbeitung entwickelt wurden. Metadaten – sofern überhaupt vorhanden – werden in Tabellenkalkulationen dokumentiert, in Datenwörterbüchern versteckt oder sind nur im Wissen der Entwickler vorhanden, die die ursprünglichen Systeme erstellt haben. Datenpipelines sind Einzelkonstruktionen, die nie für die großflächige Versorgung einer produktiven KI-Anwendung ausgelegt waren.
Das Ergebnis: Jede KI-Initiative beginnt auf der Datenebene praktisch bei null. Qualitätsprüfungen werden uneinheitlich durchgeführt. Governance wird erst nachträglich implementiert. Generische ML-Plattformen bieten zwar Werkzeuge für die Modellentwicklung, aber nicht die geregelte Datenerfassung, die semantische Schicht oder die produktionsreifen Qualitätskontrollen, die diese Werkzeuge für die Anwendung auf reale Unternehmensdaten zuverlässig machen. Kunden entwickeln diese Schichten selbst – weshalb KI-Initiativen regelmäßig länger dauern und mehr kosten als ursprünglich geplant.
Drei Ebenen, drei unterschiedliche Aufgaben
Die Speicherschicht ist der Punkt, an dem Governance entweder beginnt oder dauerhaft aufgeschoben wird. ACID-Transaktionen , Schemaentwicklung und Time-Travel-Abfragen sind keine Performance-Merkmale, sondern Governance-Anforderungen. Schemaentwicklung ist wichtig, da sich die Quellsysteme von Unternehmen kontinuierlich ändern; eine Speicherschicht, die diese Änderungen nicht aufnehmen kann, wird zum Flaschenhals für jede darüber liegende KI-Initiative. Time-Travel-Abfragen ermöglichen es regulierten Unternehmen, historische Prüfungsfragen ohne manuelle Datenrekonstruktion zu beantworten. Die bei der Datenerfassung erzwungene Aufbewahrung eliminiert eine ganze Klasse von Compliance-Risiken, die die meisten Organisationen derzeit eher durch Prozesse und Dokumentation als durch Architektur managen. Solix bietet dies durch ein auf Apache Hudi basierendes, verwaltetes Lakehouse und eine dedizierte Preservation Zone für Unternehmensanwendungsdaten, wobei Aufbewahrung und Legal-Hold-Funktionen ab dem Zeitpunkt des Dateneingangs aktiv sind.
Die Metadatenebene ist der Ort, an dem Daten Bedeutung erhalten – und wo die meisten KI-Grundlagen in Unternehmen am schwächsten sind. Ein Datenbankschema beschreibt die vorhandenen Felder, nicht aber deren Bedeutung oder ihre Beziehungen zwischen Anwendungen. Ein KI-System, das mit einem Rohschema arbeitet, leitet daraus geschäftliche Bedeutungen ab, die ihm nicht bekannt sind, und erzeugt so Ergebnisse, die sich weder erklären noch auf eine Quelle zurückführen lassen. Ein Application Knowledge Graph schließt diese Lücke: eine semantische Ebene, die die Geschäftsobjekte, Beziehungen, das Vokabular und die getesteten Abfragemuster einer Unternehmensanwendung kodiert. Solix liefert vorkonfigurierte Application Knowledge Graphs für Oracle EBS , SAP ECC/S4HANA , PeopleSoft und JD Edwards – und entlastet damit den Kunden von der zeitaufwändigsten Aufgabe der semantischen Erstellung. Für unstrukturierte Inhalte wendet ein beim Import erstellter semantischer Index dasselbe Prinzip an: Die Bedeutung wird kodiert, bevor ein Modell sie verarbeitet. Das Ergebnis sind KI-Antworten, die sich auf eine zertifizierte Geschäftsdefinition zurückführen lassen und mit Überzeugung einer Aufsichtsbehörde oder einem Vorstand präsentiert werden können.
Die Pipeline-Ebene bestimmt die Zuverlässigkeit aller nachgelagerten KI-Ergebnisse. Automatisierte Profilerstellung, Qualitätsregeln, Herkunftsverfolgung und Workflows zur Datenaufbereitung stellen sicher, dass Probleme bereits bei der Datenerfassung erkannt werden – und nicht erst, nachdem eine fehlerhafte KI-Empfehlung eine Geschäftsentscheidung beeinflusst hat. Solix strukturiert dies in vier aufeinanderfolgende, kontrollierte Phasen: Datenerfassung, kontrolliertes Datenrepository, Datenqualität und ML-Flow. Jede dieser Phasen ist auditierbar und verkürzt die Zeit zwischen Dateneingang und Produktionsbereitschaft für die KI.
Wie eine produktionsreife Stiftung aussieht
Stellen Sie sich ein Finanzdienstleistungsunternehmen vor, das Oracle EBS- und SAP-Daten mit Echtzeit-Betriebsdaten und archivierten Datensätzen aus stillgelegten Anwendungen konsolidiert. Das Ziel: eine KI-gestützte Plattform für Risiko- und Betriebsanalyse mit Zugriff in natürlicher Sprache für Geschäftsanwender und einer strukturierten Grundlage für Data-Science-Teams.
Auf der Speicherebene landen die Daten in einem kontrollierten Datenspeicher mit ACID-Transaktionen , Schemaentwicklung und Zeitreiseabfragen für regulatorische Zwecke. Daten älterer Anwendungen werden in eine kontrollierte Aufbewahrungszone verschoben – dort werden die Aufbewahrungsfristen verwaltet und die Daten sind von Anfang an für die rechtliche Aufbewahrung bereit.
Auf der Metadatenebene werden vorkonfigurierte Application Knowledge Graphs für Oracle EBS und SAP an die spezifische Konfiguration des Unternehmens angepasst und bilden die Wertströme von der Beschaffung bis zur Zahlung, von der Auftragsabwicklung bis zum Zahlungseingang und von der Datenerfassung bis zum Berichtswesen ab. Ein einheitlicher Anlagenkatalog verwaltet zertifizierte Geschäftsdefinitionen und die Datenherkunft im gesamten System. Wenn ein Business-Analyst die Daten in natürlicher Sprache abfragt oder ein Risikomodell die Daten analysiert, lässt sich die Antwort auf eine zertifizierte Definition zurückführen – und nicht auf eine Ableitung aus einer Rohdatentabelle.
Auf der Pipeline-Ebene greifen Qualitätsregeln, bevor die Daten ein Modell erreichen. Die Datenherkunft verfolgt jedes Element von der Quelle bis zum KI-fähigen Produkt. Das Data-Science-Team arbeitet mit geprüften Daten – nicht mit monatelanger, individueller Datenaufbereitung, die vor dem Training des ersten Modells durchgeführt werden muss.
Drei Fragen vor der nächsten Ausweitung der KI-Initiative
Bevor man sich auf die nächste Phase der KI-Investitionen einlässt, lohnt es sich, dem Team direkt drei Fragen zur Datenarchitektur zu stellen.
Gelangen Daten von Anfang an in eine kontrollierte Umgebung – mit Qualitätsprüfung, Aufbewahrungsrichtlinien und Prüfprotokollen, die bereits bei der Erfassung durchgesetzt werden – oder wird die Datenverwaltung erst im Nachhinein angewendet, wenn ein Problem auftritt? Organisationen, die die erste Frage nicht beantworten können, tragen ein Compliance-Risiko, das mit jeder darauf basierenden KI-Anwendung steigt.
Verfügen die KI-Systeme, die diese Daten verarbeiten, über eine semantische Schicht, die die geschäftliche Bedeutung kodiert, oder arbeiten sie direkt mit den Rohdaten? Ohne eine solche Schicht lassen sich die Ergebnisse der KI nicht zuverlässig nachverfolgen, erklären oder verteidigen.
Liefern die Datenpipelines, die KI-Modelle speisen, aufbereitete, nachvollziehbare Datenprodukte oder Rohdaten, die jede neue Initiative separat aufbereiten muss? Letzteres bedeutet, dass die Kosten für die Datenaufbereitung wiederholt anfallen – einmal pro Initiative statt einmalig für die Grundlage.
Wenn sich eine dieser Fragen als schwieriger erweist als sie sein sollte, dann beginnt dort die Architekturprüfung – und dort beginnt der Entwurf für skalierbare KI im Unternehmen.

Stephen Tallant
Vizepräsident für Produktmarketing
HAFTUNGSAUSSCHLUSS: DIE IN DIESEM BLOG AUSGEDRÜCKTEN INHALTE, ANSICHTEN UND MEINUNGEN STELLEN AUSSCHLIESSLICH DIE DES/DER AUTORS/AUTOREN DAR UND SPIEGELN NICHT DIE OFFIZIELLE RICHTLINIE ODER POSITION VON SOLIX TECHNOLOGIES, INC., SEINEN VERBUNDENEN UNTERNEHMEN ODER PARTNERN WIDER. DIESER BLOG WIRD UNABHÄNGIG BETRIEBEN UND VON SOLIX TECHNOLOGIES, INC. NICHT OFFIZIELL ÜBERPRÜFT ODER UNTERSTÜTZT. ALLE HIER VERWEISTEN MARKEN, LOGOS UND URHEBERRECHTLICH GESCHÜTZTEN MATERIALIEN DRITTER SIND EIGENTUM IHRER JEWEILIGEN EIGENTÜMER. JEGLICHE VERWENDUNG ERFOLGT AUSSCHLIESSLICH ZU IDENTIFIZIERUNGS-, KOMMENTAR- ODER BILDUNGSZWECKEN GEMÄSS DER DOKTRIN DES FAIR USE (US COPYRIGHT ACT § 107 UND INTERNATIONALE ENTSPRECHENDE BESTIMMUNGEN). KEINE STILLSCHWEIGENDE SPONSORING, UNTERSTÜTZUNG ODER VERBINDUNG MIT SOLIX TECHNOLOGIES, INC. IST VORLIEGEND. INHALTE WERDEN „WIE BESEHEN“ BEREITGESTELLT, OHNE GEWÄHRLEISTUNG DER GENAUIGKEIT, VOLLSTÄNDIGKEIT ODER EIGNUNG FÜR EINEN BESTIMMTEN ZWECK. SOLIX TECHNOLOGIES, INC. LEHNT JEGLICHE HAFTUNG FÜR MASSNAHMEN AB, DIE AUF GRUNDLAGE DIESES MATERIALS GETROFFEN WERDEN. DIE LESER ÜBERNEHMEN DIE VOLLE VERANTWORTUNG FÜR IHRE VERWENDUNG DIESER INFORMATIONEN. SOLIX RESPEKTIERT GEISTIGE EIGENTUMSRECHTE. UM EINEN ANTRAG AUF LÖSUNG GEMÄSS DMCA ZU STELLEN, SENDEN SIE EINE E-MAIL AN INFO@SOLIX.COM MIT: (1) DER IDENTIFIZIERUNG DES WERKES, (2) DER URL DES VERLETZENDEN MATERIALS, (3) IHREN KONTAKTDATEN UND (4) EINER ERKLÄRUNG IN GUTEN GLAUBEN. GÜLTIGE ANSPRÜCHE WERDEN UMGEHEND BEARBEITET. DURCH DEN ZUGRIFF AUF DIESEN BLOG ERKLÄREN SIE SICH MIT DIESEM HAFTUNGSAUSSCHLUSS UND UNSEREN NUTZUNGSBEDINGUNGEN EINVERSTANDEN. DIESE VEREINBARUNG UNTERLIEGT DEN GESETZEN KALIFORNIENS.
-
 White Paper (ENG)
Unternehmensinformationsarchitektur für KI und maschinelles Lernen der zweiten Generation
Herunterladen White Paper -
-
-
 White Paper (ENG)
Enterprise Intelligence: Die Grundlage für den Erfolg von KI schaffen
Herunterladen White Paper