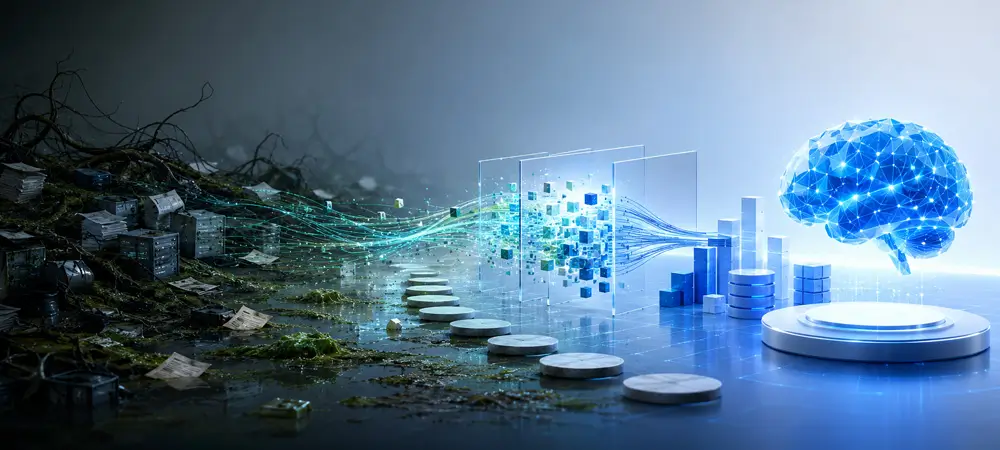
Die meisten Unternehmensdaten sind nicht komplex. Sie sind unreguliert.
Organisationen bezeichnen ihre Datenumgebung als komplex, meinen damit aber etwas Präziseres: Daten haben sich in Systemen angesammelt, die nie für deren gemeinsame Nutzung konzipiert wurden, ausrangierte Anwendungen enthalten jahrzehntelange Geschäftsgeschichte in Formaten, die das aktuelle Team noch nie gesehen hat, Metadaten existieren nur in Tabellenkalkulationen oder im Gedächtnis von Ingenieuren, die möglicherweise nicht mehr zur Verfügung stehen, und jede KI-Initiative beginnt auf die gleiche Weise – mit monatelanger Datenaufbereitung, bevor das erste Modell trainiert werden kann.
Das ist keine Komplexität, sondern fehlende Steuerung. Diese Unterscheidung ist wichtig, denn Komplexität impliziert ein architektonisches Problem – es erfordert neue Plattformen, Investitionen und Infrastruktur. Ungesteuerte Daten hingegen sind ein strukturelles Problem, das sich durch eine definierte Abfolge von Entscheidungen lösen lässt, beginnend mit dem Zeitpunkt des Dateneingangs.
Drei Phasen, eine Sequenz
Der Weg vom Datensumpf zur KI-fähigen Ressource verläuft in drei Phasen: Ad-hoc-Daten, verwaltete Daten und optimierte Daten. Die meisten Unternehmen überschätzen ihren Fortschritt. Die Diagnose ist einfach: Benötigt eine KI-Initiative monatelange Datenaufbereitung, bevor das erste Modell trainiert werden kann, handelt es sich um Ad-hoc-Daten. Lassen sich KI-Ausgaben nicht auf eine Quelle zurückführen, fehlt die semantische Ebene. Lautet die Antwort auf die Frage „Wer kann diese Daten abfragen?“ „Das Datenteam, nachdem ein Ticket erstellt wurde“, ist die optimierte Phase noch nicht erreicht.
Die drei Phasen bilden kein Spektrum, sondern eine Abfolge. Gesteuert zu sein ist Voraussetzung für optimiert zu sein. Die Organisationen, die den optimierten Zustand am schnellsten erreichen, sind diejenigen, die jede Phase als bewusste Planungsentscheidung behandelt haben – und nicht als zufälliges Ergebnis.
Phase Eins: Ad-hoc – Hier befinden sich die meisten Unternehmensdaten.
In der Ad-hoc-Phase sind Daten zwar vorhanden, aber nicht zuverlässig nutzbar. Sie landen in Speichersystemen, die für die Transaktionsverarbeitung konzipiert wurden. Ausgemusterte Anwendungen enthalten Finanzdaten, Beschaffungsdaten und Kundentransaktionen – jahrelange oder jahrzehntelange Geschäftsgeschichte –, doch die Anwendung, die den Kontext für diese Daten lieferte, wurde stillgelegt. Was bleibt, ist oft kryptisch: Tabellennamen, die für den ursprünglichen Entwickler aussagekräftig waren, Spaltenkonventionen, die von Software aus einem anderen Jahrzehnt übernommen wurden, und Beziehungen, die in der Anwendungslogik statt im Datenbankschema kodiert sind.
Die Kosten fallen bei jedem KI-Projekt von Anfang an an. Datenverarbeitungsteams entwickeln für jedes neue Projekt maßgeschneiderte Datenaufnahmepipelines. Qualitätskontrollen sind uneinheitlich oder fehlen ganz. Governance-Richtlinien – Aufbewahrungsfristen, Zugriffskontrollen, Klassifizierung – sind zwar irgendwo dokumentiert, werden aber in den Systemen, in denen die Daten tatsächlich gespeichert sind, nicht durchgesetzt. Jedes Projekt baut auf denselben Grundlagen auf. Der Business Case für KI-Investitionen wird bereits vor dem Training des ersten Modells untergraben, da die benötigten Daten nicht verfügbar sind.
Phase Zwei: Managed – Governance vor Intelligence
Die verwaltete Phase beginnt mit der Datenerfassung. Die Daten gelangen in eine geschützte Umgebung, in der Aufbewahrungsrichtlinien ab dem ersten Byte durchgesetzt werden, Qualitätsprüfungen durchgeführt werden, bevor die Daten ein nachgelagertes System erreichen, Datensätze anhand der unternehmenseigenen Taxonomie klassifiziert werden und die Möglichkeit zur rechtlichen Aufbewahrung ab dem Zeitpunkt des Dateneingangs aktiv ist. Es handelt sich hierbei nicht um eine Speichererweiterung, sondern um eine strukturelle Änderung der Datenerfassung – eine Preservation-Zone-Architektur, die einen geschützten, zentralen Speicherort für Daten aus stillgelegten Anwendungen, übernommenen Systemen und aktiven Produktionsumgebungen unter einem einheitlichen Richtlinienmodell bietet.
Die Durchsetzungsebene ist in die Governance-Plattform integriert: Datenaufbewahrung erfolgt in Echtzeit, die Zugriffsmaskierung wird durchgesetzt, und jede Governance-Maßnahme wird in einem unveränderlichen Audit-Trail protokolliert. Die Managementphase erzeugt keine KI-Ergebnisse. Sie generiert Daten, die vertrauenswürdig genug sind, um als Grundlage für weitere Entwicklungen zu dienen – klassifiziert, validiert, verwaltet und rechtlich abgesichert. Organisationen, die diese Phase erreichen, haben das Compliance-Problem gelöst. Was sie noch nicht gelöst haben, ist das Problem der Sinnhaftigkeit.
Phase Drei: Optimiert – Wenn Daten zum Treibstoff werden
Verwaltete Daten werden KI-fähig, sobald eine semantische Schicht hinzugefügt wird. Diesen Übergang lassen die meisten generischen Plattformen aus – und er entscheidet darüber, ob KI mit verifizierter Geschäftsbedeutung oder einem abgeleiteten Schema arbeitet. Ein Datenbankschema identifiziert die vorhandenen Felder. Es kodiert jedoch nicht, was diese Felder repräsentieren, wie sie in den Wertschöpfungsketten des Unternehmens zusammenhängen oder was ein gültiges Abfragemuster im Kontext der Anwendung ausmacht. Wenn ein KI-System mit einem rohen Schema arbeitet, rät es lediglich. Die generierten Antworten lassen sich weder erklären noch nachverfolgen oder als Grundlage für Geschäftsentscheidungen nutzen.
Ein Application Knowledge Graph schließt diese Lücke: Er kodiert die Geschäftsobjekte, Beziehungen, das Vokabular und die getesteten Abfragemuster einer Unternehmensanwendung. Solix liefert vorkonfigurierte Application Knowledge Graphs für Oracle EBS , SAP ECC/S4HANA , PeopleSoft und JD Edwards – die ERP-Systeme, die den Großteil der strukturierten Unternehmensdaten enthalten – und erstellt mithilfe KI-gestützter Erkennung individuelle Knowledge Graphs für Legacy- und übernommene Anwendungen ohne entsprechende vorkonfigurierte Lösung. Für unstrukturierte Inhalte erstellt Content Intelligence die semantische Schicht über Dokumenten, Verträgen und Datensätzen, sodass diese zusammen mit strukturierten Daten über eine einheitliche Schnittstelle abgefragt werden können.
Mit der semantischen Schicht können Anwender Fragen in natürlicher Sprache stellen und erhalten geprüfte, nachvollziehbare Antworten, die auf zertifizierten Geschäftsdefinitionen basieren. Data-Science-Teams entwickeln KI-Anwendungen auf einer Grundlage, die bereits geprüft, klassifiziert und semantisch angereichert ist – anstatt Monate mit der Aufbereitung von Daten zu verbringen, die von Anfang an bereit sein sollten. Gespeicherte Daten verursachen keine Infrastrukturkosten mehr, sondern werden, wie es im Whitepaper „Solix Enterprise Data Preservation“ heißt , zum „Treibstoff für intelligente Analysen, Erkenntnisse und Entscheidungen“.
Eine Diagnose, keine Aspiration.
Das Reifegradmodell ist nur dann nützlich, wenn es ehrlich angewendet wird. Drei Fragen helfen dabei, den tatsächlichen Entwicklungsstand einer Organisation zu ermitteln.
Werden Daten von Anfang an in einer kontrollierten Umgebung verarbeitet – also bereits bei der Erfassung klassifiziert, qualitätsgeprüft und unter Einhaltung von Aufbewahrungsfristen gesichert – oder erfolgt die Datenverwaltung erst im Nachhinein, wenn Fragen zur Einhaltung von Vorschriften auftauchen? Organisationen, die diese Frage nicht beantworten können, tragen ein Risiko, das mit jeder darauf basierenden KI-Anwendung steigt.
Gibt es eine semantische Schicht, die die geschäftliche Bedeutung der vom Unternehmen eingesetzten Anwendungen kodiert, oder arbeiten KI-Systeme mit rohen Schemata und erschließen Kontexte, die ihnen nicht vorliegen? Ohne eine solche Schicht lassen sich KI-Ausgaben nicht zuverlässig nachverfolgen, erklären oder überzeugend präsentieren.
Können Geschäftsanwender die Daten direkt in natürlicher Sprache abfragen – mit Antworten, die auf zertifizierten Definitionen basieren und auf eine Quelle zurückführbar sind – oder benötigt jede Frage immer noch ein Datenteam und eine Ticketwarteschlange?
Die Differenz zwischen „Nein“ und „Ja“ bei jeder dieser Fragen entspricht der Differenz zwischen improvisierten und KI-fähigen Lösungen. Diese Differenz ist überbrückbar – jedoch nur in einer bestimmten Reihenfolge und nur, wenn jede Phase als bewusste Entscheidung und nicht als Ergebnis historischer Gegebenheiten betrachtet wird.

Stephen Tallant
Vizepräsident für Produktmarketing
HAFTUNGSAUSSCHLUSS: DIE IN DIESEM BLOG AUSGEDRÜCKTEN INHALTE, ANSICHTEN UND MEINUNGEN STELLEN AUSSCHLIESSLICH DIE DES/DER AUTORS/AUTOREN DAR UND SPIEGELN NICHT DIE OFFIZIELLE RICHTLINIE ODER POSITION VON SOLIX TECHNOLOGIES, INC., SEINEN VERBUNDENEN UNTERNEHMEN ODER PARTNERN WIDER. DIESER BLOG WIRD UNABHÄNGIG BETRIEBEN UND VON SOLIX TECHNOLOGIES, INC. NICHT OFFIZIELL ÜBERPRÜFT ODER UNTERSTÜTZT. ALLE HIER VERWEISTEN MARKEN, LOGOS UND URHEBERRECHTLICH GESCHÜTZTEN MATERIALIEN DRITTER SIND EIGENTUM IHRER JEWEILIGEN EIGENTÜMER. JEGLICHE VERWENDUNG ERFOLGT AUSSCHLIESSLICH ZU IDENTIFIZIERUNGS-, KOMMENTAR- ODER BILDUNGSZWECKEN GEMÄSS DER DOKTRIN DES FAIR USE (US COPYRIGHT ACT § 107 UND INTERNATIONALE ENTSPRECHENDE BESTIMMUNGEN). KEINE STILLSCHWEIGENDE SPONSORING, UNTERSTÜTZUNG ODER VERBINDUNG MIT SOLIX TECHNOLOGIES, INC. IST VORLIEGEND. INHALTE WERDEN „WIE BESEHEN“ BEREITGESTELLT, OHNE GEWÄHRLEISTUNG DER GENAUIGKEIT, VOLLSTÄNDIGKEIT ODER EIGNUNG FÜR EINEN BESTIMMTEN ZWECK. SOLIX TECHNOLOGIES, INC. LEHNT JEGLICHE HAFTUNG FÜR MASSNAHMEN AB, DIE AUF GRUNDLAGE DIESES MATERIALS GETROFFEN WERDEN. DIE LESER ÜBERNEHMEN DIE VOLLE VERANTWORTUNG FÜR IHRE VERWENDUNG DIESER INFORMATIONEN. SOLIX RESPEKTIERT GEISTIGE EIGENTUMSRECHTE. UM EINEN ANTRAG AUF LÖSUNG GEMÄSS DMCA ZU STELLEN, SENDEN SIE EINE E-MAIL AN INFO@SOLIX.COM MIT: (1) DER IDENTIFIZIERUNG DES WERKES, (2) DER URL DES VERLETZENDEN MATERIALS, (3) IHREN KONTAKTDATEN UND (4) EINER ERKLÄRUNG IN GUTEN GLAUBEN. GÜLTIGE ANSPRÜCHE WERDEN UMGEHEND BEARBEITET. DURCH DEN ZUGRIFF AUF DIESEN BLOG ERKLÄREN SIE SICH MIT DIESEM HAFTUNGSAUSSCHLUSS UND UNSEREN NUTZUNGSBEDINGUNGEN EINVERSTANDEN. DIESE VEREINBARUNG UNTERLIEGT DEN GESETZEN KALIFORNIENS.
-
 White Paper (ENG)
Unternehmensinformationsarchitektur für KI und maschinelles Lernen der zweiten Generation
Herunterladen White Paper -
-
-
 White Paper (ENG)
Enterprise Intelligence: Die Grundlage für den Erfolg von KI schaffen
Herunterladen White Paper