ARCHIVAGE DES DONNÉES DES ESSAIS CLINIQUES — PARTIE 5/5
La première partie de cette série traitait de la transformation d'un centre de coûts en actif stratégique. La deuxième partie abordait l'utilisation des données rétrospectives pour l'entraînement de l'IA. La troisième partie montrait comment la charge d'archivage liée aux fusions-acquisitions pouvait devenir un atout. La quatrième partie décrivait comment les silos applicatifs pouvaient évoluer vers une véritable interopérabilité. Ce cinquième et dernier article s'intéresse à la question suivante : que se passe-t-il lorsqu'il faut récupérer rapidement l'ensemble des données d'une étude pour répondre à une question complexe ?
Plus tôt cette année, la FDA a demandé aux fabricants de retirer la mise en garde concernant les pensées suicidaires de trois médicaments amaigrissants à base d'agonistes du GLP-1 : Saxenda, Wegovy et Zepbound. Cette demande faisait suite à un examen entamé en juillet 2023, date à laquelle l'agence a reçu les premiers signalements d'un lien possible. L'analyse finale a regroupé 91 essais contrôlés par placebo portant sur 107 910 patients, ainsi qu'une étude distincte menée en conditions réelles auprès de plus de 2.2 millions de patients. Conclusion : aucun risque accru. La mise en garde a été retirée.
À bien y regarder, l'essentiel n'est pas le résultat lui-même, mais le chemin parcouru pour y parvenir. Certains de ces 91 essais remontent au milieu des années 2000, menés selon des protocoles différents par des équipes différentes, bien avant que cette question précise ne soit posée. Y répondre a nécessité l'extraction de données individuelles de chaque patient de ces études et leur regroupement en un seul ensemble de données. Il ne s'agit pas d'une simple recherche, mais d'un problème d'extraction de données à l'échelle de l'étude entière, et non d'un champ ou d'un formulaire isolé.
La plupart des systèmes de recherche de données cliniques ne sont pas encore conçus pour cela. Ils fonctionnent au niveau de l'application : on se connecte au système de saisie électronique des données (EDC) pour vérifier une information, au dossier médical électronique (eTMF) pour une autre, et à une base de données de pharmacovigilance pour une troisième. Chaque recherche est rapide prise individuellement, mais c'est l'intégration de toutes ces informations dans un dossier d'étude complet et fiable qui prend réellement du temps.
Ce temps perdu a un coût réel et non négligeable. Dans le domaine de la recherche biomédicale en général, une analyse économique largement citée estime le coût annuel des recherches précliniques non reproductibles aux États-Unis à environ 28 milliards de dollars, dont une grande partie ne peut être vérifiée ni reconstituée à partir des données enregistrées. Les essais cliniques sont menés avec plus de rigueur que les travaux précliniques, mais le même problème sous-jacent se pose : les données techniquement conservées quelque part ne sont pas équivalentes aux données réellement récupérables, complètes et prêtes à être réanalysées.
Ce type de données « récupérables » porte un nom : le modèle de données des résultats d’analyse (ARDM) . Au lieu de se limiter aux données brutes, il traite les résultats d’analyse eux-mêmes : les tableaux, les statistiques et les figures produits par une étude sont considérés comme des données structurées, lisibles par machine et réutilisables, et non comme un PDF statique impossible à interroger. Le principe est simple : « écrire une fois, être disponible indéfiniment ». Un résultat calculé pour un usage donné reste accessible pour un usage ultérieur, au lieu d’être figé dans un document et recalculé à chaque fois.
Les quatre exemples ci-dessous démontrent qu'il est impossible d'attribuer l'écart de récupération à un seul mauvais essai.
Un essai, 2026. Une équipe a reproduit les résultats d'un essai clinique déjà publié. Ce travail a mobilisé plusieurs centaines d'heures de travail réparties entre cinq équipes distinctes : le dictionnaire de données original était introuvable et les valeurs initiales statistiques nécessaires à la reproduction des résultats n'avaient jamais été enregistrées. Non pas parce que les données étaient inexistantes, mais parce que le lien vers le protocole de l'essai était rompu. Conclusion de l'article : sans l'ensemble du dossier d'étude (protocole, dictionnaire et méthodologie), la réutilisation est quasiment impossible.
Réplication en situation réelle , 2019. Des chercheurs ont tenté de reproduire 220 essais cliniques américains publiés dans des revues à fort impact à partir de données réelles (dossiers médicaux électroniques et données de remboursement d'assurance). Seuls 33 essais, soit 15 %, ont pu être reproduits. La plupart des échecs étaient liés à la même cause fondamentale que cette série met régulièrement en lumière : l'intervention, les critères d'inclusion ou le critère d'évaluation principal n'avaient pas été enregistrés de manière structurée et accessible en dehors des systèmes de l'essai initial.
Soins intensifs, 2018. Une analyse exploratoire de 158 pratiques cliniques issues d'essais cliniques en soins intensifs a révélé qu'une tentative de reproduction n'a été effectuée que pour 66 d'entre elles (42 %). Parmi celles-ci, 56 % ont produit des résultats incohérents avec l'étude initiale. Deux pratiques initialement jugées sûres et efficaces se sont avérées nocives après un réexamen approfondi ; la réanimation liquidienne par hydroxyéthylamidon était la plus fortement associée à des preuves de nocivité. En moyenne, il a fallu 4.6 ans avant qu'une vérification ne soit entreprise.
Revues systématiques, 2016. La recherche elle-même était souvent difficilement reproductible. Une analyse de 272 revues systématiques publiées dans 25 revues a révélé que seulement 13 % d'entre elles présentaient une stratégie de recherche suffisamment détaillée pour être reproduite dans toutes les bases de données utilisées. Les termes de recherche étaient mentionnés dans 91 % des cas, mais la base de données utilisée et la date d'exécution de la recherche étaient rarement précisées.
Et il ne s'agit pas seulement d'un problème de récupération : les résultats rapportés peuvent différer des données initialement prévues. Une analyse distincte des enregistrements d'essais cliniques a révélé un écart médian de 31 % entre les critères d'évaluation principaux enregistrés et publiés, atteignant même 100 % dans certaines études, et un écart médian de 54 % pour les critères d'évaluation secondaires. Lorsque les résultats ont été modifiés a posteriori, ils ont favorisé un résultat statistiquement significatif dans environ la moitié des cas.
C’est pourquoi l’industrie et la réglementation s’orientent vers une récupération des données au niveau de l’étude, et non plus au niveau de l’application. L’EMA exige la publication proactive des rapports complets des études cliniques depuis l’entrée en vigueur de sa politique 0070 en 2016, et non plus seulement des résultats sommaires. Les comités de rédaction des revues, par l’intermédiaire de l’ICMJE, exigent un plan de partage des données pour les essais cliniques depuis 2018. Des plateformes à but non lucratif comme Vivli existent précisément pour permettre aux chercheurs de demander des données complètes d’une étude, et non des documents épars provenant de multiples systèmes. Rien de tout cela ne peut fonctionner si « l’étude » n’existe que sous forme de fragments de données répartis dans des applications non connectées.
Les 5 exigences essentielles pour la recherche au niveau de l'étude :
- Un seul identifiant permanent pour l'ensemble de l'étude. Non pas un identifiant par document ou ensemble de données, mais un seul identifiant qui relie le protocole, les données de l'étude, le code d'analyse et le rapport d'étude clinique (REC) en une seule unité récupérable.
- Un ensemble complet, et pas seulement le jeu de données.La réanalyse de l'essai unique de 2026 sert d'avertissement : les données brutes, sans protocole, dictionnaire ni méthodes d'analyse, ne sont pas réutilisables. Le modèle de données des résultats d'analyse (ARDM) va plus loin.
- Une seule requête centralisée au lieu de cinq connexions distinctesUn chercheur ou un organisme de réglementation doit pouvoir extraire une étude complète en une seule opération, et non la reconstruire à partir de l'EDC, de l'eTMF et d'un référentiel de statistiques.
- Méthodologie enregistrée, jusqu'au numéro de graineLa reproductibilité exacte à ce niveau de détail dépend des spécificités de chaque situation. Si l'erreur n'est pas détectée sur le moment, elle ne pourra pas être récupérée ultérieurement.
- Les études anciennes et nouvelles sont accessibles de la même manière.L'analyse du GLP-1 nécessitait de regrouper les essais cliniques du milieu des années 2000 avec ceux des années 2020. Un système de recherche qui ne fonctionne que pour les études des années précédentes n'est pas un système de recherche du tout : c'est juste une solution de facilité temporaire.
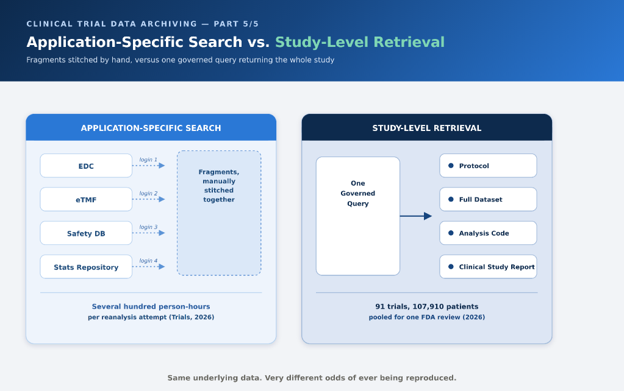
L'évaluation de la sécurité des agonistes du GLP-1 représente la version positive de cette histoire. Pour répondre à la question « existe-t-il réellement un risque de suicide ? », il a fallu traiter des décennies d'essais cliniques sur Saxenda, menés bien avant que cette question ne soit posée, comme des données exploitables et regroupables, au même titre que les essais plus récents sur Wegovy et Zepbound. Cela n'est possible que si l'intégralité des données d'un essai est conservée sous forme d'un ensemble cohérent et accessible, et non comme un simple dossier de fichiers ayant miraculeusement subsisté dans le système qui les a créés. Grâce à cela, l'agence a pu regrouper 91 essais et trancher une question de sécurité cruciale en s'appuyant sur des données concrètes plutôt que sur des conjectures : l'avertissement a été levé, et non aggravé.
Tout ce qui figure dans cette liste correspond en réalité aux principes FAIR introduits dans la partie 3 de cette série, appliqués au niveau de l'étude plutôt qu'au niveau du dossier individuel :
- TrouvableChaque étude possède un identifiant unique et permanent, et non des identifiants de documents dispersés dans des systèmes distincts.
- AccessibleUn processus de récupération contrôlé permet de retrouver l'étude complète sur demande, et non de procéder à une recherche manuelle dans différents systèmes.
- CompatibleLes études anciennes et les nouvelles études utilisent une structure qui leur permet d'être intégrées à une même analyse groupée sans nécessiter de projet de traduction.
- RéutilisableLe protocole, le dictionnaire de données, les méthodes d'analyse et les résultats sont transmis ensemble, de sorte que la réanalyse ne dépend pas de la mémorisation de détails que personne n'a notés.
Si vous omettez l'une de ces étapes, la recherche au niveau de l'étude se transforme discrètement en une recherche spécifique à l'application, techniquement possible, mais pratiquement lente, et à un lien brisé près d'un résultat non reproductible.
Ceci conclut cette série d'articles, et il convient donc d'en souligner clairement le fil conducteur. Chaque article abordait un problème différent : justification des coûts, pertinence de l'IA, avantages des fusions-acquisitions, prolifération des applications, résultats de la recherche . En réalité, chacun d'eux posait la même question, sous un angle différent : vos données sont-elles suffisamment bien gouvernées pour être trouvées, considérées comme fiables et réutilisées par une personne qui n'était pas présente lors de leur création ?
- Dimension 1 - Centre de coûts vers actif stratégiqueLes données d'essais cliniques archivées, bien réutilisées, permettront de raccourcir les délais de développement.
- Dimension 2 - Rétroviseur vers les données d'entraînementCes mêmes archives constituent la matière première des modèles d'IA, à condition que leur provenance soit documentée avec autant de rigueur que le modèle lui-même.
- Dimension 3 - Le fardeau des archives au service d'un avantage unifiéLes fusions-acquisitions multiplient les archives ; les principes FAIR permettront aux données de deux entreprises de devenir une seule ressource utilisable au lieu de deux classeurs distincts.
- Dimension 4 - Des silos d'applications à une véritable interopérabilitéLes applications de pointe peuvent coexister avec une réelle interopérabilité, mais seulement si une couche de données commune et gouvernée les sous-tend toutes.
- Dimension 5 — Recherche spécifique à l'application pour la récupération au niveau de l'étudeTout ce qui précède n'est utile que si l'étude complète peut être extraite, intégralement et de manière reproductible, en cas de besoin.
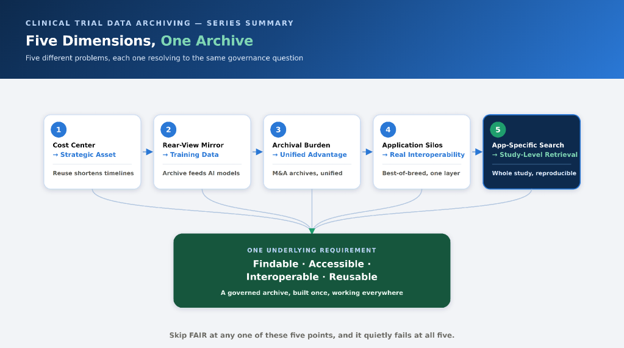
Cinq problèmes distincts, une exigence sous-jacente : des données trouvables, accessibles, interopérables et réutilisables — pour l’IA, pour les fusions-acquisitions, pour les applications qui les génèrent, et pour le moment où quelqu’un doit reproduire l’étude dans son intégralité.
Aucune de ces cinq dimensions n'est optionnelle prise individuellement, et aucune ne fonctionne isolément. Une archive peu coûteuse à créer et à réutiliser, mais incapable d'alimenter un modèle d'IA, de s'unifier après une acquisition, de résister à une architecture applicative multi-fournisseurs ou d'être restaurée intégralement sous la pression réglementaire, n'est pas véritablement aboutie. Le concept FAIR n'a jamais porté sur un seul de ces cinq problèmes, mais sur leur ensemble.
Si votre organisation applique également l'IA à ce type de problème en amont du processus de développement, le livre blanc de mon collègue Rohit Pardeshi et Soumith Babburi mérite d'être consulté : il présente un cadre d'utilisation d'une infrastructure de données connectées pour accélérer le repositionnement de médicaments et l'identification de cibles grâce à l'IA. Ce cadre repose sur la même logique d'« étude globale, et non pas seulement d'un domaine » que défend ce blog, appliquée ici à la décision des prochaines recherches plutôt qu'à la justification des travaux déjà menés. Un cadre pour le repositionnement de médicaments et l'identification de cibles grâce à l'IA dans la R&D pharmaceutique.
Si vous travaillez dans les domaines de la biostatistique, des affaires réglementaires ou de la gestion des données : si un organisme de réglementation demandait demain à votre organisation de rassembler tous les essais cliniques menés sur un produit au cours des quinze dernières années, récupéreriez-vous l’étude complète ou la reconstruiriez-vous, application par application ?
FAQ
Qu’est-ce que la récupération au niveau de l’étude dans la gestion des données d’essais cliniques ?
La récupération au niveau de l'étude consiste à récupérer une étude clinique complète sous forme d'un ensemble unique, fiable et contrôlé, au lieu de rechercher des enregistrements individuels dans différentes applications. Elle relie le protocole, les données de l'étude, les méthodes d'analyse et le rapport d'étude clinique afin que l'étude puisse être récupérée et réutilisée dans son intégralité.
Quelle est la différence entre la recherche spécifique à une application et la recherche au niveau de l'étude ?
La recherche par application permet de récupérer les informations système par système, comme un système de saisie électronique des données (EDC), un dossier patient informatisé (eTMF) ou une base de données de pharmacovigilance. La recherche au niveau de l'étude permet d'accéder à l'étude complète via une seule requête, réduisant ainsi la nécessité de reconstituer manuellement les informations provenant de plusieurs systèmes non connectés.
Pourquoi la récupération des données au niveau de l'étude est-elle importante pour les essais cliniques ?
La récupération des données au niveau de l'étude facilite leur recherche, leur accès, leur analyse, leur reproduction et leur réutilisation. La conservation des données seules ne suffit pas ; le protocole, le dictionnaire de données, la méthodologie et les résultats associés doivent également rester accessibles et liés entre eux.
Que doit contenir un dossier complet de données d'essai clinique ?
Un dossier complet d'essai clinique doit inclure le protocole d'étude, les données de l'étude, le dictionnaire de données, le code ou les méthodes d'analyse, et le rapport d'étude clinique. Ces éléments fournissent le contexte nécessaire à la compréhension, à la reproduction et à la réutilisation de l'étude, évitant ainsi de se fier uniquement aux données brutes.
Qu’est-ce que le modèle de données des résultats d’analyse (ARDM) ?
Le modèle de données des résultats d'analyse (ARDM) considère les résultats d'analyse, tels que les tableaux, les statistiques et les figures, comme des données structurées, lisibles par machine et réutilisables, et non comme des documents statiques. Cette approche permet de récupérer les résultats d'analyse pour une utilisation ultérieure sans avoir à les recalculer intégralement.
Comment la récupération des données au niveau des études contribue-t-elle à la reproductibilité des essais cliniques ?
La récupération des données au niveau de l'étude favorise la reproductibilité en centralisant les informations nécessaires à la reproduction d'une étude. Cela inclut le protocole, le dictionnaire de données, les méthodes d'analyse et d'autres détails méthodologiques, y compris des informations précises telles que les valeurs d'ensemencement statistique, le cas échéant.
Quelles sont les cinq exigences essentielles pour la recherche au niveau de l'étude ?
Les cinq exigences essentielles sont un identifiant unique et permanent pour l'ensemble de l'étude, un dossier d'étude complet, une requête unique et contrôlée au lieu de multiples recherches dans l'application, une méthodologie enregistrée et une récupération cohérente des études historiques et nouvelles.
Comment les principes FAIR s'appliquent-ils à la récupération des données des essais cliniques ?
Les principes FAIR rendent les données des essais cliniques faciles à trouver, accessibles, interopérables et réutilisables. Au niveau de l'étude, cela implique l'utilisation d'identifiants d'étude persistants, une récupération encadrée des données, des structures compatibles et la conservation conjointe du protocole, des données, des méthodes et des résultats.
Comment la récupération des données au niveau des études contribue-t-elle à l'examen réglementaire et à l'analyse de la sécurité ?
L’extraction de données au niveau des études permet aux chercheurs et aux autorités réglementaires d’accéder à l’ensemble des données d’essais cliniques et de les regrouper lorsqu’ils examinent des questions importantes de sécurité ou de réglementation. L’analyse de sécurité du GLP-1 illustre comment les essais historiques peuvent être extraits et combinés à des études plus récentes pour répondre à une question de sécurité précise.
Pourquoi les anciens essais cliniques devraient-ils être récupérables en utilisant la même approche que les nouveaux essais ?
Il peut s'avérer nécessaire de combiner des études historiques avec des études plus récentes à des fins d'évaluation réglementaire, d'analyse de sécurité ou de recherche. Un système de recherche documentaire devrait donc permettre d'accéder aux études anciennes et nouvelles selon une même approche standardisée, plutôt que de limiter la recherche aux données les plus récentes.
Références
- Agence américaine des produits alimentaires et médicamenteux (FDA), « La FDA demande la suppression de l’avertissement relatif aux comportements et aux idées suicidaires figurant sur les médicaments GLP-1 RA » (avril 2026) — fda.gov/drugs/drug-safety-communications/fda-requests-removal-suicidal-behavior-and-ideation-warning-glucagon-peptide-1-receptor-agonist-glp
- Science News, « La recherche en sciences de la vie non reproductible aux États-Unis coûte 28 milliards de dollars », rapportant Freedman, Cockburn et Simcoe, « L'économie de la reproductibilité dans la recherche préclinique », PLOS Biology (2015) — sciencenews.org/article/irreproducible-life-sciences-research-us-costs-28-billion
- Kirchner et al., « Repenser les données des études cliniques : pourquoi nous devrions respecter les résultats d'analyse en tant que données », Scientific Data (2022) — nature.com/articles/s41597-022-01789-2
- Ansari et al., « La reproductibilité des stratégies de recherche est faible dans les revues systématiques publiées dans des revues à fort impact en pédiatrie, cardiologie et chirurgie », PLOS One (2016) — journaux.plos.org/plosone/article?id=10.1371/journal.pone.0163309
- Essais cliniques (Springer Nature), « Soutenir la réanalyse et la réutilisation des données d'essais cliniques : une étude de cas » (2026) — lien.springer.com/article/10.1186/s13063-026-09646-y
- Niven et al., « Reproductibilité de la recherche clinique en soins intensifs : une revue exploratoire », BMC Medicine (2018) — link.springer.com/article/10.1186/s12916-018-1018-6
- Franklin et al., « Faisabilité de l’utilisation de données réelles pour reproduire les résultats d’essais cliniques », JAMA Network Open (2020) — jamanetwork.com/journals/jamanetworkopen/fullarticle/2752575
- Jones et al., « Comparaison des résultats enregistrés et publiés dans les essais contrôlés randomisés : une revue systématique », BMC Medicine (2015) — link.springer.com/article/10.1186/s12916-015-0520-3
- New England Journal of Medicine, « Transparence et Agence européenne des médicaments — Partage des données des essais cliniques » (2015) — nejm.org/doi/full/10.1056/NEJMp1409464
- Wilkinson et al., « Les principes directeurs FAIR pour la gestion et la gouvernance des données scientifiques », Scientific Data (2016) — nature.com/articles/sdata201618
- Vivli, plateforme mondiale à but non lucratif de partage de données de recherche clinique — vivli.org
#EssaisCliniques #GestionDesDonnéesCliniques #SciencesDeLaVie #Reproductibilité #DonnéesFAIR #StratégieDesDonnées #DéveloppementDeMédicaments #AffairesRéglementaires

Murali Krishnam
Vice-président – Stratégie produit, IA pour l'industrie pharmaceutique
AVERTISSEMENT : LE CONTENU, LES POINTS DE VUE ET LES OPINIONS EXPRIMÉS DANS CE BLOG SONT LA RESPONSABILITÉ EXCLUSIVE DES AUTEURS ET NE REFLÈTENT PAS LA POLITIQUE OU LA POSITION OFFICIELLE DE SOLIX TECHNOLOGIES, INC., DE SES SOCIÉTÉS AFFILIÉES OU DE SES PARTENAIRES. CE BLOG EST EXPLOITÉ DE MANIÈRE INDÉPENDANTE ET N'EST NI RÉVISÉ NI APPROUVÉ PAR SOLIX TECHNOLOGIES, INC. À TITRE OFFICIEL. TOUTES LES MARQUES, LOGOS ET DOCUMENTS PROTÉGÉS PAR LE DROIT D'AUTEUR TIERS MENTIONNÉS DANS CE BLOG APPARTIENNENT À LEURS PROPRIÉTAIRES RESPECTIFS. TOUTE UTILISATION EST STRICTEMENT À DES FINS D'IDENTIFICATION, DE COMMENTAIRE OU ÉDUCATIVES CONFORMÉMENT À LA DOCTRINE DE L'US FAIR USE (US COPYRIGHT ACT § 107 ET ÉQUIVALENTS INTERNATIONAUX). AUCUN PARRAINAGE, AUCUNE APPROBATION OU AFFILIATION AVEC SOLIX TECHNOLOGIES, INC. N'EST IMPLICITE. LE CONTENU EST FOURNI « EN L'ÉTAT », SANS GARANTIE D'EXACTITUDE, D'EXHAUSTIVITÉ OU D'ADÉQUATION À UN USAGE PARTICULIER. SOLIX TECHNOLOGIES, INC. DÉCLINE TOUTE RESPONSABILITÉ POUR LES ACTIONS PRISES SUR LA BASE DE CE MATÉRIEL. LES LECTEURS ASSUMENT L'ENTIÈRE RESPONSABILITÉ DE LEUR UTILISATION DE CES INFORMATIONS. SOLIX RESPECTE LES DROITS DE PROPRIÉTÉ INTELLECTUELLE. POUR SOUMETTRE UNE DEMANDE DE RETRAIT DMCA, ENVOYEZ UN E-MAIL À INFO@SOLIX.COM AVEC : (1) L'IDENTIFICATION DE L'ŒUVRE, (2) L'URL DU MATÉRIEL CONTREFAÇANT, (3) VOS COORDONNÉES ET (4) UNE DÉCLARATION DE BONNE FOI. TOUTE RÉCLAMATION VALIDE RECEVRA UNE EXAMEN RAPIDE. EN ACCÉDANT À CE BLOG, VOUS ACCEPTEZ CET AVIS DE NON-RESPONSABILITÉ ET NOS CONDITIONS D'UTILISATION. CE CONTRAT EST RÉGI PAR LES LOIS DE LA CALIFORNIE.
-
 Publication
Architecture de l'information d'entreprise pour l'IA générale et l'apprentissage automatique
Télécharger le livre blanc -
-
-
 Publication
Intelligence d'entreprise : construire les bases du succès de l'IA
Télécharger le livre blanc