La conversation que la plupart des programmes d'IA n'ont pas
Les organisations qui passent d'un projet pilote d'IA à un programme d'IA ont un point commun : elles ont résolu la question de l'architecture avant que le passage à l'échelle ne la révèle. Elles ont défini les caractéristiques nécessaires de l'infrastructure de données – en termes de propriétés de stockage, de couches sémantiques et de contrôles du pipeline – avant même le déploiement de la deuxième ou de la troisième application en production.
La plupart des projets ne suivent pas cette séquence. On choisit le modèle, on définit les cas d'utilisation, on élabore des preuves de concept, et on considère l'infrastructure de données comme un aspect qui sera traité au fur et à mesure du développement du programme. Dans les environnements d'entreprise, cette hypothèse est systématiquement à l'origine des retards – et des coûts – lors du passage à l'échelle.
Accessible ne signifie pas compatible avec l'IA.
La distinction souvent négligée lors de la planification initiale des programmes d'IA est celle entre les données accessibles et les données prêtes pour l'IA.
Les données accessibles peuvent être interrogées . Elles existent dans un système, peuvent être extraites et un modèle peut les exploiter. La plupart des données d'entreprise répondent à ce critère. Les données prêtes pour l'IA sont gérées dès leur ingestion, possèdent une signification sémantique vérifiée, ont fait l'objet d'un contrôle qualité avant d'être intégrées à un modèle et leur traçabilité est garantie de la source jusqu'à la réponse, sans interruption.
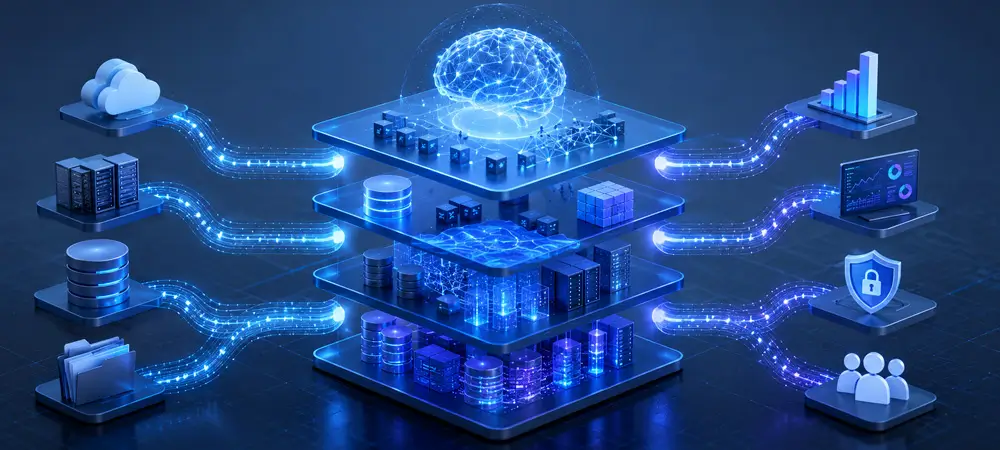
L'écart entre ces deux définitions est d'ordre architectural, et non lié à un projet de qualité des données. Il est impossible de gérer les données a posteriori à l'échelle qu'exige l'IA d'entreprise. Les trois couches qui déterminent la scalabilité de l'IA d'entreprise – stockage, métadonnées et pipelines – ont chacune une fonction distincte et créent les conditions nécessaires à la couche suivante.
Pourquoi les fondations sont toujours la dernière chose construite
La plupart des environnements de données d'entreprise n'ont pas été conçus pour l'IA. Les données sont stockées dans des systèmes destinés au traitement transactionnel. Les métadonnées, lorsqu'elles existent, sont consignées dans des tableurs, enfouies dans des dictionnaires de données ou simplement mémorisées par les ingénieurs ayant conçu les systèmes d'origine. Les pipelines sont des solutions ponctuelles, jamais conçues pour alimenter une application d'IA en production à grande échelle.
Résultat : chaque initiative d’IA repart de zéro au niveau des données. Les contrôles qualité sont appliqués de manière incohérente. La gouvernance est ajoutée a posteriori. Les plateformes de ML génériques fournissent des outils pour le développement de modèles, mais pas pour l’ingestion contrôlée, la couche sémantique ni les contrôles qualité de niveau production qui garantissent la fiabilité de ces outils sur les données réelles de l’entreprise. Les clients développent eux-mêmes ces couches, ce qui explique pourquoi les initiatives d’IA prennent systématiquement plus de temps et coûtent plus cher que prévu dans l’étude de cas initiale.
Trois niveaux, trois emplois distincts
La couche de stockage est le point de départ ou le lieu où la gouvernance est définitivement reportée. Les transactions ACID , l'évolution des schémas et les requêtes temporelles ne sont pas des fonctionnalités de performance, mais des exigences de gouvernance. L'évolution des schémas est cruciale car les systèmes sources d'entreprise évoluent constamment ; une couche de stockage incapable d'absorber ces changements devient un goulot d'étranglement pour toute initiative d'IA située au-dessus. Les requêtes temporelles permettent aux entreprises réglementées de répondre aux questions d'audit historiques sans reconstruction manuelle des données. La conservation des données, appliquée dès l'ingestion, élimine toute une catégorie de risques de non-conformité que la plupart des organisations gèrent actuellement par le biais de processus et de documentation plutôt que par leur architecture. Solix propose cette solution grâce à un lac de données gouverné basé sur Apache Hudi et une zone de préservation dédiée aux données des applications d'entreprise, avec des capacités de conservation et de mise sous séquestre légal activées dès l'arrivée des données.
La couche de métadonnées est l'endroit où les données acquièrent du sens – et c'est là que la plupart des fondations de l'IA d'entreprise sont les plus fragiles. Un schéma de base de données indique les champs existants, mais pas leur signification ni leurs relations entre les applications. Un système d'IA qui raisonne sur un schéma brut infère un sens métier qui lui fait défaut, produisant des résultats inexplicables et introuvables. Un graphe de connaissances applicatives comble cette lacune : une couche sémantique encodant les objets métier, les relations, le vocabulaire et les modèles de requêtes testés, spécifiques à une application d'entreprise. Solix propose des graphes de connaissances applicatives préconfigurés pour Oracle EBS , SAP ECC/S4HANA , PeopleSoft et JD Edwards , déchargeant ainsi le client de la tâche la plus chronophage : la création sémantique. Pour les contenus non structurés, un index sémantique créé lors de l'ingestion applique le même principe : le sens est encodé avant qu'un modèle ne les analyse. Il en résulte des réponses d'IA traçables à une définition métier certifiée et pouvant être présentées avec assurance à un organisme de réglementation ou à un conseil d'administration.
La couche pipeline détermine la fiabilité de chaque résultat d'IA en aval. Le profilage automatisé, les règles de qualité, le suivi de la lignée des données et les flux de travail de préparation des données garantissent la détection des problèmes dès l'ingestion, et non après qu'une recommandation d'IA erronée ait déjà influencé une décision métier. Solix structure ce processus en quatre étapes séquentielles et contrôlées : ingestion, lac de données contrôlé, qualité des données et flux d'apprentissage automatique. Chaque étape est auditable et contribue à réduire le délai entre l'arrivée des données et leur mise en production pour l'IA.
À quoi ressemble une fondation prête pour la production
Prenons l'exemple d'un organisme de services financiers qui consolide ses données Oracle EBS et SAP, ainsi que ses flux opérationnels en temps réel et les archives d'applications obsolètes. L'objectif : une plateforme d'intelligence opérationnelle et de gestion des risques basée sur l'IA, accessible via une interface en langage naturel pour les utilisateurs métiers et dotée d'une infrastructure sécurisée pour les équipes de data science.
Au niveau du stockage, les données sont acheminées vers un lac de données contrôlé, avec transactions ACID , évolution du schéma et requêtes temporelles pour la conformité réglementaire. Les données des applications existantes sont déplacées vers une zone de préservation contrôlée , gérée pour la conservation et conforme aux exigences légales dès leur arrivée.
Au niveau des métadonnées, des graphes de connaissances applicatifs préconfigurés pour Oracle EBS et SAP sont adaptés à l'organisation et encodent les flux de valeur des processus d'approvisionnement, de facturation et de reporting. Un catalogue d'actifs unifié garantit la traçabilité et la conformité des définitions métier certifiées au sein du système. Ainsi, lorsqu'un analyste métier interroge les données en langage naturel ou qu'un modèle de risque les analyse, la réponse est associée à une définition certifiée, et non à une simple inférence à partir d'une table brute.
Au niveau du pipeline, des règles de qualité sont appliquées avant même que les données n'atteignent un modèle. La traçabilité assure le suivi de chaque élément, de la source au produit prêt pour l'IA. L'équipe de science des données travaille à partir de données gouvernées, et non de mois d'ingénierie de données sur mesure effectués avant même l'entraînement du premier modèle.
Trois questions à se poser avant de passer à l'échelle supérieure avec la prochaine initiative en matière d'IA
Avant de s'engager dans la prochaine phase d'investissement en IA, il convient de poser directement à l'équipe trois questions concernant l'architecture des données.
Les données sont-elles intégrées à un environnement contrôlé dès leur acquisition – avec validation de la qualité, politiques de conservation et pistes d'audit appliquées dès le départ – ou la gouvernance intervient-elle a posteriori, lorsqu'un problème survient ? Les organisations incapables de répondre à cette première question s'exposent à un risque de non-conformité croissant avec chaque application d'IA déployée.
Les systèmes d'IA qui traitent ces données possèdent-ils une couche sémantique qui encode le sens métier, ou raisonnent-ils directement sur des schémas bruts ? Sans cela, les résultats de l'IA ne peuvent être ni retracés, ni expliqués, ni justifiés de manière fiable.
Les pipelines alimentent-ils les modèles d'IA en produisant des données contrôlées et traçables, ou s'agit-il de données brutes que chaque nouvelle initiative doit réorganiser indépendamment ? Dans ce dernier cas, il faut supporter les coûts d'ingénierie des données à chaque initiative, au lieu d'un coût unique pour l'ensemble de la fondation.
Si l'une de ces questions s'avère plus difficile à résoudre qu'elle ne devrait l'être, c'est là que commence l'analyse de l'architecture – et que débute le plan directeur d'une IA d'entreprise évolutive.

Stephen Tallant
Vice-président du marketing produit
AVERTISSEMENT : LE CONTENU, LES POINTS DE VUE ET LES OPINIONS EXPRIMÉS DANS CE BLOG SONT LA RESPONSABILITÉ EXCLUSIVE DES AUTEURS ET NE REFLÈTENT PAS LA POLITIQUE OU LA POSITION OFFICIELLE DE SOLIX TECHNOLOGIES, INC., DE SES SOCIÉTÉS AFFILIÉES OU DE SES PARTENAIRES. CE BLOG EST EXPLOITÉ DE MANIÈRE INDÉPENDANTE ET N'EST NI RÉVISÉ NI APPROUVÉ PAR SOLIX TECHNOLOGIES, INC. À TITRE OFFICIEL. TOUTES LES MARQUES, LOGOS ET DOCUMENTS PROTÉGÉS PAR LE DROIT D'AUTEUR TIERS MENTIONNÉS DANS CE BLOG APPARTIENNENT À LEURS PROPRIÉTAIRES RESPECTIFS. TOUTE UTILISATION EST STRICTEMENT À DES FINS D'IDENTIFICATION, DE COMMENTAIRE OU ÉDUCATIVES CONFORMÉMENT À LA DOCTRINE DE L'US FAIR USE (US COPYRIGHT ACT § 107 ET ÉQUIVALENTS INTERNATIONAUX). AUCUN PARRAINAGE, AUCUNE APPROBATION OU AFFILIATION AVEC SOLIX TECHNOLOGIES, INC. N'EST IMPLICITE. LE CONTENU EST FOURNI « EN L'ÉTAT », SANS GARANTIE D'EXACTITUDE, D'EXHAUSTIVITÉ OU D'ADÉQUATION À UN USAGE PARTICULIER. SOLIX TECHNOLOGIES, INC. DÉCLINE TOUTE RESPONSABILITÉ POUR LES ACTIONS PRISES SUR LA BASE DE CE MATÉRIEL. LES LECTEURS ASSUMENT L'ENTIÈRE RESPONSABILITÉ DE LEUR UTILISATION DE CES INFORMATIONS. SOLIX RESPECTE LES DROITS DE PROPRIÉTÉ INTELLECTUELLE. POUR SOUMETTRE UNE DEMANDE DE RETRAIT DMCA, ENVOYEZ UN E-MAIL À INFO@SOLIX.COM AVEC : (1) L'IDENTIFICATION DE L'ŒUVRE, (2) L'URL DU MATÉRIEL CONTREFAÇANT, (3) VOS COORDONNÉES ET (4) UNE DÉCLARATION DE BONNE FOI. TOUTE RÉCLAMATION VALIDE RECEVRA UNE EXAMEN RAPIDE. EN ACCÉDANT À CE BLOG, VOUS ACCEPTEZ CET AVIS DE NON-RESPONSABILITÉ ET NOS CONDITIONS D'UTILISATION. CE CONTRAT EST RÉGI PAR LES LOIS DE LA CALIFORNIE.
-
 Publication
Architecture de l'information d'entreprise pour l'IA générale et l'apprentissage automatique
Télécharger le livre blanc -
-
-
 Publication
Intelligence d'entreprise : construire les bases du succès de l'IA
Télécharger le livre blanc