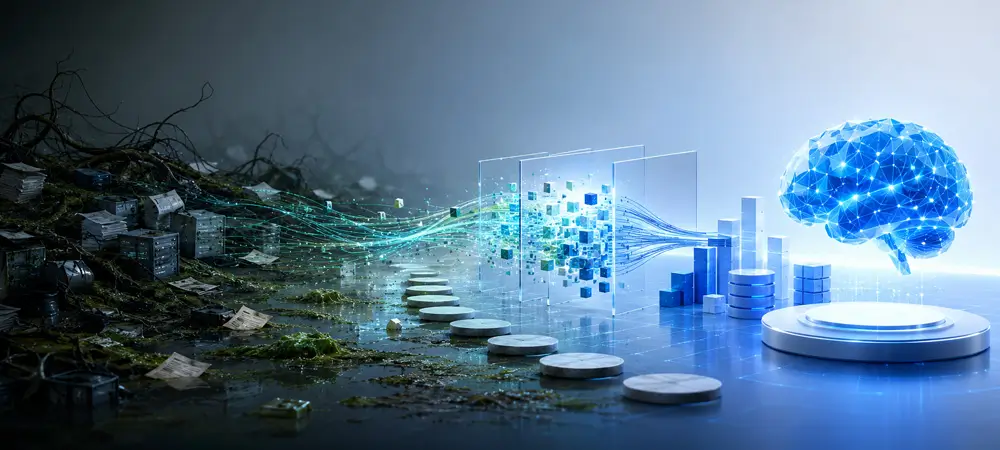
La plupart des données d'entreprise ne sont pas complexes. Elles ne sont pas gouvernées.
Les organisations qualifient leur environnement de données de complexe alors qu'elles veulent dire quelque chose de plus précis : les données se sont accumulées dans des systèmes qui n'ont jamais été conçus pour être partagés, des applications obsolètes contiennent des décennies d'historique d'activité dans des formats que l'équipe actuelle n'a jamais vus, les métadonnées n'existent que dans des feuilles de calcul ou dans la mémoire d'ingénieurs qui ne sont peut-être plus disponibles, et chaque initiative en matière d'IA commence de la même manière : des mois d'ingénierie des données avant que le premier modèle puisse être entraîné.
Il ne s'agit pas de complexité, mais d'absence de gouvernance. Cette distinction est cruciale, car la complexité sous-entend un problème architectural, nécessitant de nouvelles plateformes, de nouveaux investissements et une nouvelle infrastructure. Les données non gouvernées constituent un problème structurel, qu'une séquence de décisions bien définie peut résoudre dès leur arrivée.
Trois étapes, une séquence
Le passage d'un amas de données à un actif prêt pour l'IA se déroule en trois étapes : ad hoc, géré et optimisé. La plupart des entreprises s'imaginent être plus avancées qu'elles ne le sont réellement. Le diagnostic est simple. Si un projet d'IA nécessite des mois d'ingénierie des données avant même l'entraînement du premier modèle, les données sont ad hoc. Si les résultats de l'IA ne peuvent être rattachés à une source, la couche sémantique est absente. Si la réponse à la question « Qui peut interroger ces données ? » est « L'équipe de données, après l'ouverture d'un ticket », l'étape d'optimisation n'est pas encore atteinte.
Ces trois étapes ne forment pas un continuum, mais une séquence. La gestion est une condition préalable à l'optimisation. Les organisations qui atteignent l'état optimal le plus rapidement sont celles qui ont considéré chaque étape comme un choix stratégique, et non comme un résultat fortuit.
Étape 1 : Ad hoc — Là où se trouve la plupart des données d’entreprise
Au stade ad hoc, les données existent mais ne sont pas exploitables de manière fiable. Elles sont stockées dans des systèmes conçus pour le traitement transactionnel. Les applications obsolètes contiennent des données financières, des données d'approvisionnement et des transactions clients – des années, voire des décennies, d'historique d'activité – mais l'application qui fournissait le contexte à ces données a été mise hors service. Ce qui subsiste est souvent obscur : des noms de tables significatifs pour le développeur d'origine, des conventions de colonnes héritées de logiciels d'une autre époque et des relations codées dans la logique applicative plutôt que dans le schéma de la base de données.
Le coût est supporté dès le lancement de chaque initiative d'IA. Les équipes d'ingénierie des données conçoivent des pipelines d'ingestion sur mesure pour chaque nouveau projet. Les contrôles qualité sont incohérents, voire inexistants. La gouvernance (politiques de conservation, contrôles d'accès, classification) est documentée, mais non appliquée dans les systèmes où les données sont stockées. Chaque projet réinvente les mêmes fondations. La pertinence de l'investissement en IA est compromise avant même l'entraînement du premier modèle, car les données nécessaires à ce dernier ne sont pas prêtes.
Deuxième étape : Gérée — La gouvernance avant le renseignement
La phase de gestion débute dès l'ingestion. Les données arrivent dans un environnement contrôlé où les politiques de conservation sont appliquées dès le premier octet, des contrôles qualité sont effectués avant que les données n'atteignent un système en aval, les enregistrements sont étiquetés selon la taxonomie de l'organisation et la conservation légale est activée dès leur réception. Il ne s'agit pas d'une simple mise à niveau du stockage, mais d'une transformation structurelle de la réception des données : une architecture de zone de préservation offrant un environnement centralisé et contrôlé pour les données issues d'applications obsolètes, de systèmes acquis et d'environnements de production actifs, le tout sous un modèle de politique unique.
La couche de contrôle s'intègre à la plateforme de gouvernance : conservation des données en temps réel, masquage obligatoire à l'accès et enregistrement de chaque action de gouvernance dans une piste d'audit immuable. La phase de gestion ne produit pas de résultats d'IA. Elle génère des données suffisamment fiables pour servir de base à de nouvelles approches : classifiées, validées, gouvernées et juridiquement défendables. Les organisations qui atteignent ce stade ont résolu le problème de la conformité. Ce qu'elles n'ont pas encore résolu, c'est la question du sens.
Troisième étape : Optimisation — Quand les données deviennent carburant
Les données gérées deviennent compatibles avec l'IA lorsqu'une couche sémantique est ajoutée. C'est cette transition que la plupart des plateformes génériques omettent, et qui détermine si l'IA fonctionne sur la base d'une signification métier vérifiée ou d'un schéma inféré. Un schéma de base de données identifie les champs existants. Il n'encode ni leur signification, ni leurs relations au sein des flux de valeur de l'entreprise, ni ce qui constitue un modèle de requête valide dans le contexte de cette application. Un système d'IA qui raisonne sur un schéma brut ne fait que deviner. Les réponses qu'il produit ne peuvent être expliquées, retracées ou utilisées comme outil de décision métier.
Un graphe de connaissances applicatif comble cette lacune : il encode les objets métier, les relations, le vocabulaire et les modèles de requêtes testés propres à une application d’entreprise. Solix propose des graphes de connaissances applicatifs préconfigurés pour Oracle EBS , SAP ECC/S4HANA , PeopleSoft et JD Edwards (les systèmes ERP qui hébergent la majorité des données structurées d’entreprise) et crée des graphes de connaissances personnalisés grâce à une exploration basée sur l’IA pour les applications existantes et acquises ne disposant pas d’équivalent préconfiguré. Pour les contenus non structurés, Content Intelligence construit la couche sémantique au-dessus des documents, contrats et enregistrements, permettant ainsi de les interroger au même titre que les données structurées dans une interface unique et contrôlée.
Grâce à la couche sémantique, les utilisateurs métiers posent des questions en langage naturel et reçoivent des réponses structurées et auditables, fondées sur des définitions métiers certifiées. Les équipes de science des données développent des applications d'IA sur une base déjà structurée, classifiée et enrichie sémantiquement, au lieu de passer des mois à préparer des données qui auraient dû être prêtes dès leur réception. Les données préservées cessent d'être un coût d'infrastructure et deviennent, selon le livre blanc de Solix sur la préservation des données d'entreprise , « un carburant pour l'analyse intelligente, la découverte et la prise de décision ».
Un diagnostic, pas une aspiration
Le modèle de maturité n'est utile que s'il est appliqué avec sincérité. Trois questions permettent d'identifier la position réelle d'une organisation.
Les données sont-elles intégrées à un environnement contrôlé dès leur réception (classification, validation de la qualité et application des règles de conservation dès l'ingestion) ou la gouvernance est-elle mise en œuvre a posteriori, lorsqu'un problème de conformité se pose ? Les organisations incapables de répondre à la première question s'exposent à un risque croissant, proportionnel à chaque application d'IA déployée.
Existe-t-il une couche sémantique qui encode le sens métier des applications exécutées par l'organisation, ou les systèmes d'IA raisonnent-ils sur des schémas bruts et infèrent-ils un contexte qui leur fait défaut ? Sans une telle couche, les résultats de l'IA ne peuvent être ni retracés, ni expliqués, ni présentés avec certitude.
Les utilisateurs métiers peuvent-ils interroger directement les données en langage naturel — avec des réponses basées sur des définitions certifiées et traçables jusqu'à leur source — ou chaque question nécessite-t-elle encore une équipe de données et une file d'attente de tickets ?
La différence entre « non » et « oui » à chacune de ces questions correspond à la différence entre une approche ad hoc et une approche prête pour l'IA. Il est possible de la surmonter, mais uniquement de manière séquentielle et en considérant chaque étape comme une décision délibérée plutôt que comme le fruit du hasard.

Stephen Tallant
Vice-président du marketing produit
AVERTISSEMENT : LE CONTENU, LES POINTS DE VUE ET LES OPINIONS EXPRIMÉS DANS CE BLOG SONT LA RESPONSABILITÉ EXCLUSIVE DES AUTEURS ET NE REFLÈTENT PAS LA POLITIQUE OU LA POSITION OFFICIELLE DE SOLIX TECHNOLOGIES, INC., DE SES SOCIÉTÉS AFFILIÉES OU DE SES PARTENAIRES. CE BLOG EST EXPLOITÉ DE MANIÈRE INDÉPENDANTE ET N'EST NI RÉVISÉ NI APPROUVÉ PAR SOLIX TECHNOLOGIES, INC. À TITRE OFFICIEL. TOUTES LES MARQUES, LOGOS ET DOCUMENTS PROTÉGÉS PAR LE DROIT D'AUTEUR TIERS MENTIONNÉS DANS CE BLOG APPARTIENNENT À LEURS PROPRIÉTAIRES RESPECTIFS. TOUTE UTILISATION EST STRICTEMENT À DES FINS D'IDENTIFICATION, DE COMMENTAIRE OU ÉDUCATIVES CONFORMÉMENT À LA DOCTRINE DE L'US FAIR USE (US COPYRIGHT ACT § 107 ET ÉQUIVALENTS INTERNATIONAUX). AUCUN PARRAINAGE, AUCUNE APPROBATION OU AFFILIATION AVEC SOLIX TECHNOLOGIES, INC. N'EST IMPLICITE. LE CONTENU EST FOURNI « EN L'ÉTAT », SANS GARANTIE D'EXACTITUDE, D'EXHAUSTIVITÉ OU D'ADÉQUATION À UN USAGE PARTICULIER. SOLIX TECHNOLOGIES, INC. DÉCLINE TOUTE RESPONSABILITÉ POUR LES ACTIONS PRISES SUR LA BASE DE CE MATÉRIEL. LES LECTEURS ASSUMENT L'ENTIÈRE RESPONSABILITÉ DE LEUR UTILISATION DE CES INFORMATIONS. SOLIX RESPECTE LES DROITS DE PROPRIÉTÉ INTELLECTUELLE. POUR SOUMETTRE UNE DEMANDE DE RETRAIT DMCA, ENVOYEZ UN E-MAIL À INFO@SOLIX.COM AVEC : (1) L'IDENTIFICATION DE L'ŒUVRE, (2) L'URL DU MATÉRIEL CONTREFAÇANT, (3) VOS COORDONNÉES ET (4) UNE DÉCLARATION DE BONNE FOI. TOUTE RÉCLAMATION VALIDE RECEVRA UNE EXAMEN RAPIDE. EN ACCÉDANT À CE BLOG, VOUS ACCEPTEZ CET AVIS DE NON-RESPONSABILITÉ ET NOS CONDITIONS D'UTILISATION. CE CONTRAT EST RÉGI PAR LES LOIS DE LA CALIFORNIE.
-
 Publication
Architecture de l'information d'entreprise pour l'IA générale et l'apprentissage automatique
Télécharger le livre blanc -
-
-
 Publication
Intelligence d'entreprise : construire les bases du succès de l'IA
Télécharger le livre blanc