La semaine dernière, j'ai publié un article de blog décrivant cinq changements majeurs qui transforment l'archivage des données d'essais cliniques, d'une obligation de conformité à un élément essentiel de l'infrastructure de R&D. Voici le premier volet d'une analyse approfondie : la première dimension, la transformation d'un centre de coûts en un atout stratégique, grâce à l'utilisation des données archivées pour gagner du temps lors du démarrage et de la clôture des études.
Dans le cadre de l'opération TrialBlazer, la FDA a annoncé le 22 juin 2026 son projet pilote d'essais cliniques en temps réel (RTCT). Ce programme permet aux promoteurs de transmettre en continu à l'agence les données relatives aux critères d'évaluation et aux signaux de sécurité, et non plus seulement à des points d'analyse prédéfinis, afin d'accélérer les décisions en phase précoce. Si la FDA prévoit de nommer prochainement sa première cohorte pilote, deux essais de validation de principe sont déjà en cours et servent de modèles opérationnels : TRAVERSE d'AstraZeneca et STREAM-SCLC d'Amgen.
Le reporting en temps réel semble être l'antithèse de l'archivage. Pourtant, un signal « en temps réel » n'a de sens que si l'agence et le promoteur peuvent le comparer à des données de référence : antécédents de sécurité, données dose-réponse, résultats d'essais antérieurs dans la même indication ou des indications connexes. En résumé, un enregistrement clair, structuré et accessible des données antérieures est indispensable, tandis que les données en temps réel ne sont qu'un bruit de fond qui s'accélère. Le projet pilote RTCT repose sur le pari que les données historiques des essais des promoteurs sont enfin suffisamment bien organisées et facilement consultables pour constituer un point de référence dynamique, et non plus un simple rapport archivé.
L'approche RTCT a déjà fait ses preuves, sous une appellation moins futuriste : les groupes témoins externes (ou synthétiques), où les données d'essais antérieurs remplacent un groupe placebo nouvellement recruté. Voici quelques exemples passés :
Koselugo, 2020. La FDA a approuvé Koselugo pour le traitement de la neurofibromatose de type 1 chez l'enfant, en utilisant un groupe contrôle externe constitué d'une cinquantaine de patients issus d'une étude d'histoire naturelle et d'une cinquantaine de patients du groupe placebo de l'essai de phase II SPRINT. Dans une population pédiatrique aussi rare, le recrutement d'une nouvelle cohorte placebo aurait été long et impraticable. L'approbation reposait entièrement sur la disponibilité des données de l'essai précédent, au niveau du patient, et sur leur qualité suffisante pour permettre leur comparaison avec les données collectées et archivées il y a plusieurs années.
Alecensa, 2015. Roche a construit un groupe témoin synthétique pour son médicament contre le cancer du poumon Alecensa en utilisant des données d'essais existants au lieu de mener une nouvelle étude comparative, et a obtenu une décision de remboursement de l'UE environ 18 mois plus tôt que par la voie traditionnelle.
Blincyto, 2014. Amgen a utilisé la même approche. Des données d'essais historiques ont servi de groupe témoin afin d'accélérer l'approbation de Blincyto pour une indication rare de leucémie, pour laquelle le recrutement d'un groupe témoin complet aurait constitué un obstacle majeur.
Aucun de ces exemples ne relève de cas d'utilisation hypothétiques de l'IA ni de stratégies réglementaires approuvées par la FDA, et chacun d'eux ne fonctionne que parce que quelqu'un, des années auparavant, a jugé que les données d'un essai déjà clos méritaient d'être conservées sous une forme réutilisable : non seulement récupérables par un inspecteur, mais suffisamment structurées pour qu'un statisticien travaillant sur un programme complètement différent puisse les faire correspondre, les harmoniser et les défendre auprès d'un organisme de réglementation.
C’est là le véritable changement qui sous-tend la transformation d’un centre de coûts en atout stratégique. Il ne s’agit pas d’une promesse concernant une future capacité d’IA, mais bien de l’archive elle-même : structurée, harmonisée au niveau du patient et couvrant l’ensemble des études, elle permet déjà un démarrage plus rapide des essais et une approbation plus précoce. La RTCT représente la prochaine étape : au lieu de simplement réutiliser les données d’essais antérieurs pour une nouvelle comparaison, elle structure les données afin qu’un essai en cours puisse être comparé à cette archive en temps quasi réel. Cela n’est possible que si l’archive sous-jacente a été conçue dès le départ pour être réutilisable et consultable, et non pas simplement assemblée à la hâte pour survivre à la prochaine inspection réglementaire.
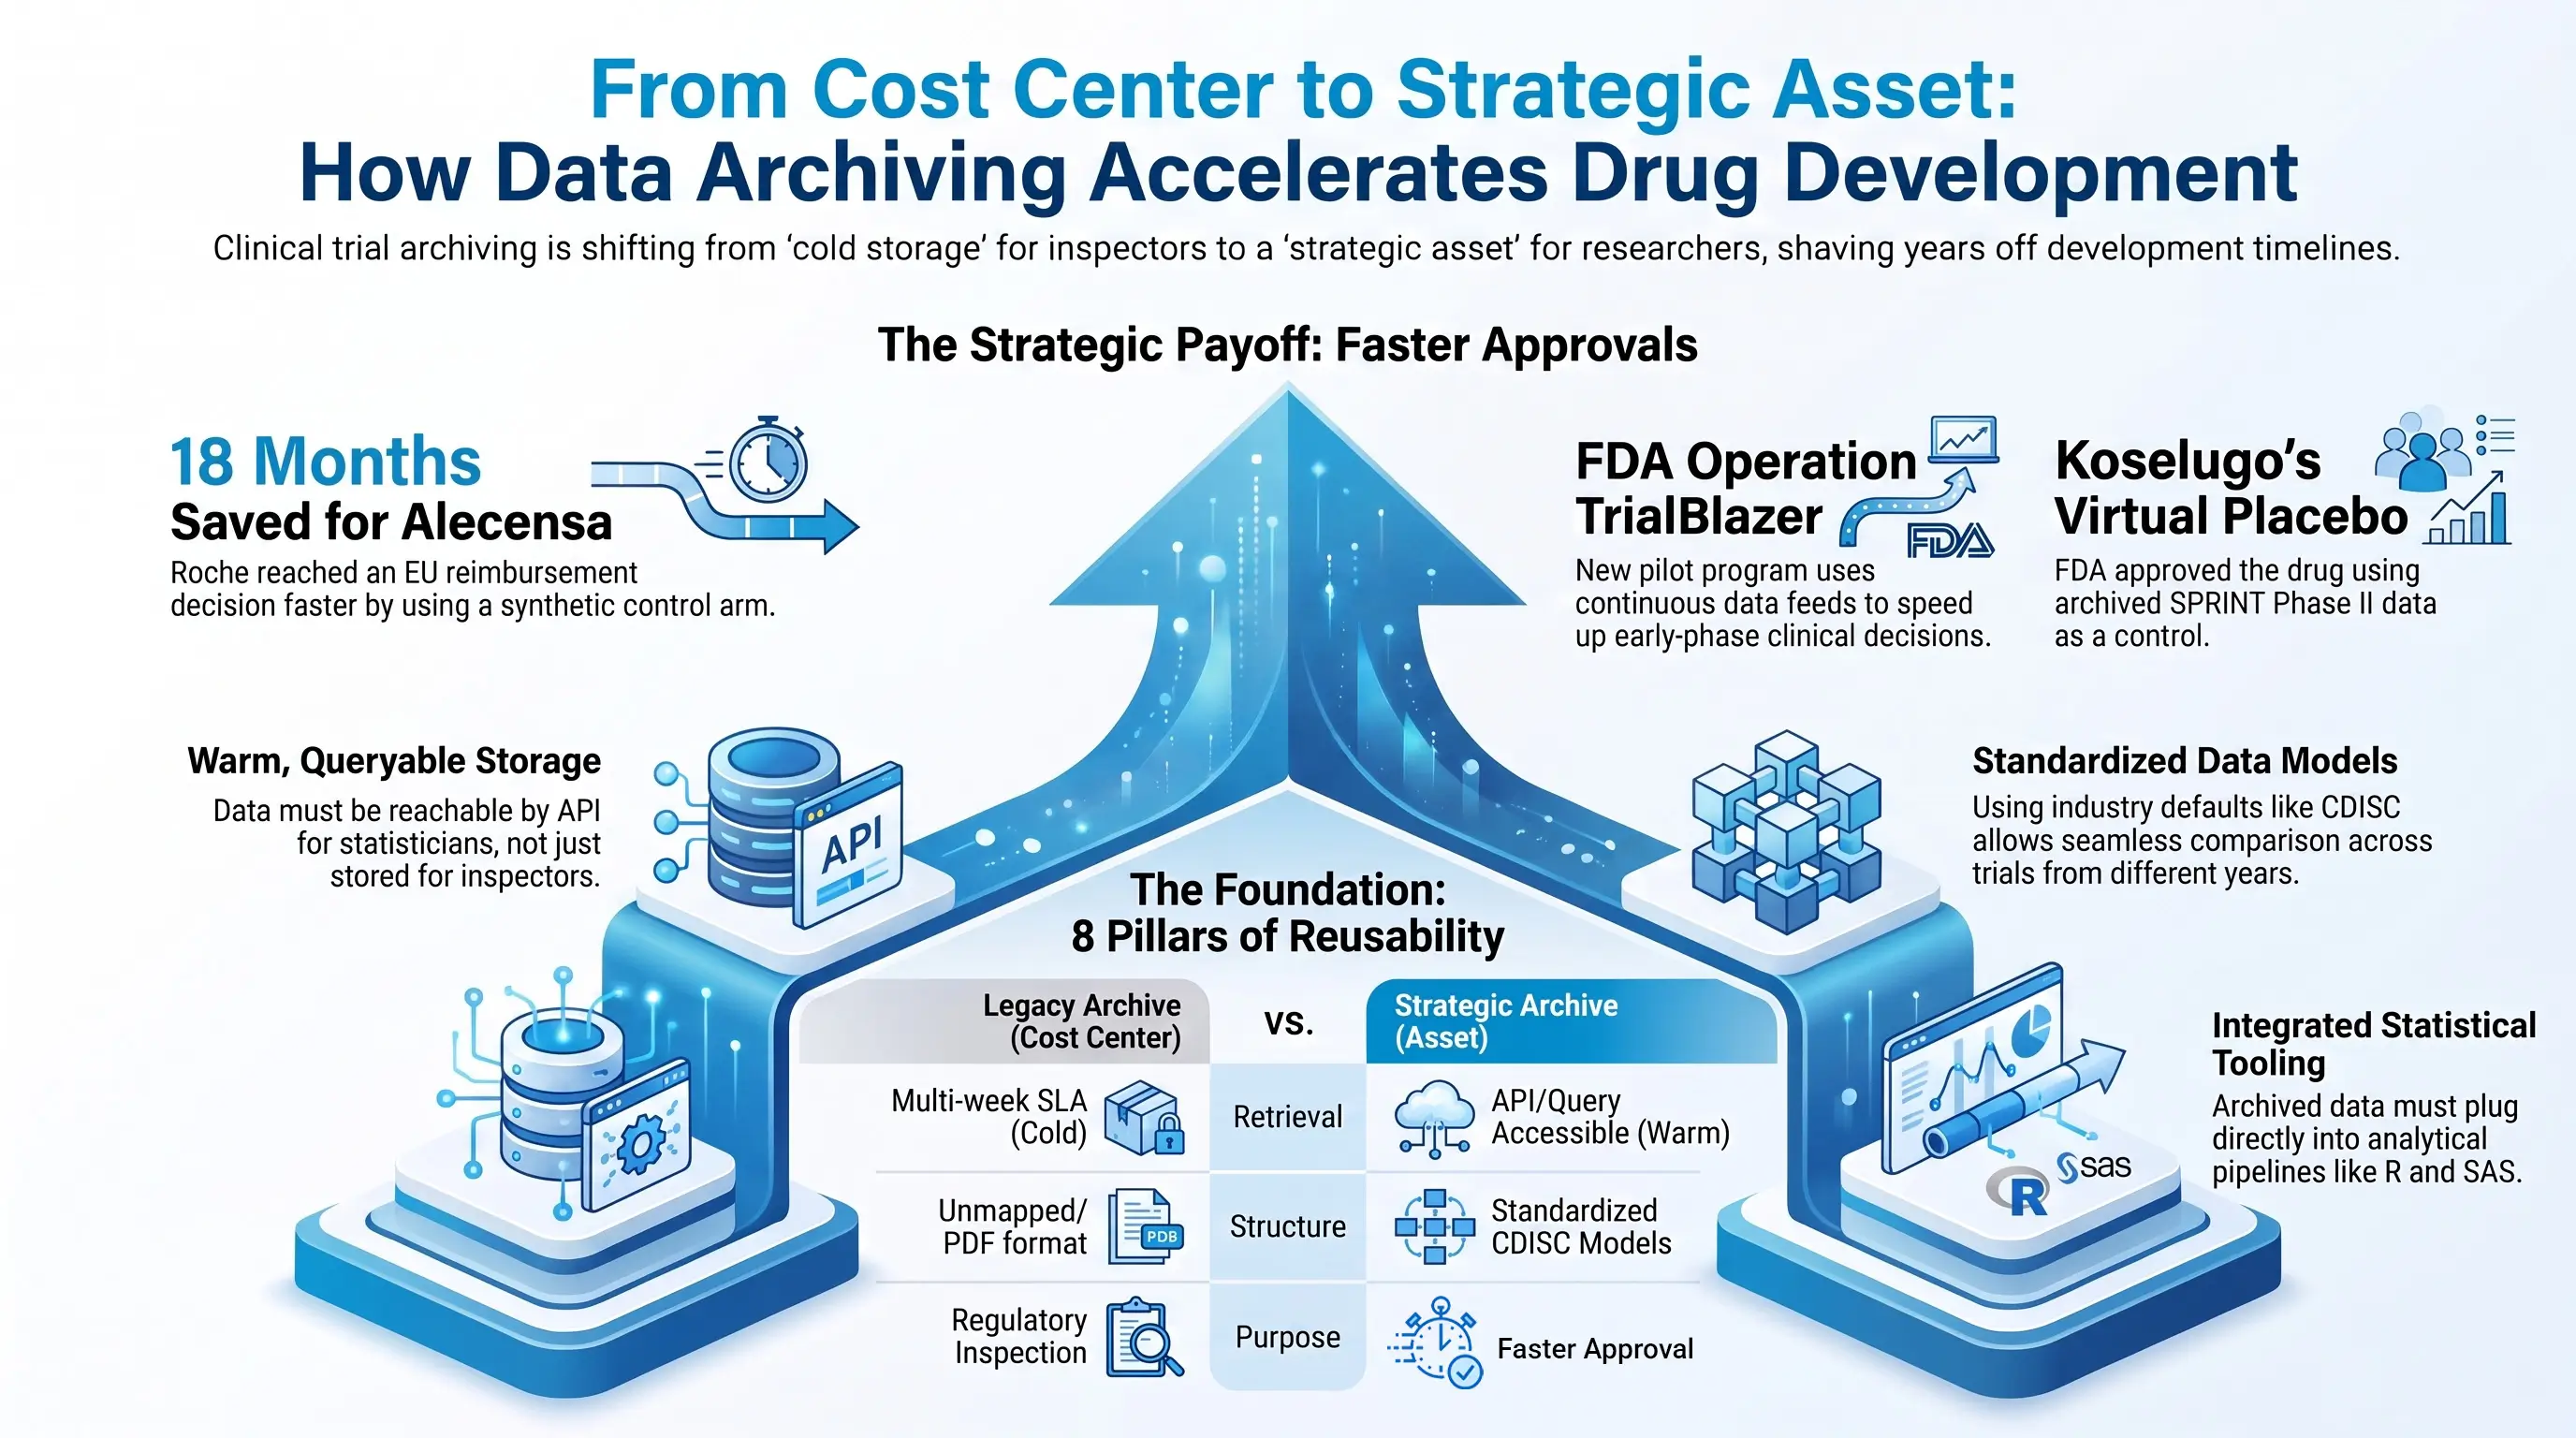
« Conçu pour être réutilisable et consultable » n’est pas un slogan, c’est une liste précise de capacités techniques, et la plupart relèvent de l’ingénierie des données fondamentales plutôt que de l’IA :
- LE FONDEMENT : Un stockage interrogeable et indexé au lieu d’archives froides. Les données conservées dans un référentiel avec un SLA de récupération de plusieurs semaines ne peuvent pas alimenter une comparaison en temps réel. Elles doivent être stockées dans un système de stockage indexé et accessible par API ou requête, conçu pour les statisticiens et les pipelines, et non pour les simples inspecteurs.
- LA STRUCTURE : Modèles de données standardisés. Les données historiques des essais cliniques doivent être mises en correspondance avec des formats de données communs (SDTM et ADaM de CDISC sont les formats par défaut du secteur), afin qu'un essai oncologique de 2026 et un essai oncologique de 2018 décrivent les événements indésirables, les doses et les critères d'évaluation de la même manière, au lieu d'un projet de réalignement manuel.
- LE CONTEXTE : Des métadonnées riches et structurées, et pas seulement les données. La provenance — version du protocole, site, population d'analyse, dosage — doit être consignée dans chaque dossier. C'est ce qui permet au statisticien de s'assurer qu'un patient de 2026 est comparable à un patient de 2018 et non qu'ils ne présentent qu'une ressemblance superficielle.
- LA SIGNIFICATION : Une couche sémantique transversale aux terminologies. Les essais cliniques utilisent des étiquettes différentes pour un même concept clinique : anciens noms de champs des CRF, codes de site locaux et versions MedDRA. Sans ontologie partagée ni graphe de connaissances permettant de concilier ces différences, l’association des patients historiques à la cohorte d’un essai en cours constitue un projet à part entière, et non une simple requête.
- L'IDENTITÉ : Dé-identification systématique et liaison au niveau du patient. La comparaison des caractéristiques initiales entre les études nécessite des données au niveau du patient et non des données agrégées, qui sont anonymisées de la même manière dans tous les essais et systèmes afin qu'un algorithme de correspondance dispose d'un élément uniforme sur lequel travailler.
- LE FIDUCIE : Piste d'audit complète et traçabilité. Les organismes de réglementation qui acceptent un comparateur historique pour le RTCT ou un bras de contrôle externe doivent retracer précisément les enregistrements, leur version et les transformations ayant servi à la comparaison. Il s'agit d'une exigence relative aux métadonnées et au versionnage, et non d'une simple formalité ajoutée lors du dépôt de la demande.
- LE CONSENTEMENT : Gouvernance liée à la portée du consentement initial. La réutilisation des données d'un patient lors d'un essai clinique à des fins réglementaires, des années plus tard, doit être vérifiée au regard du consentement du patient, ce qui signifie que la portée du consentement doit exister sous forme de métadonnées structurées, et non sous forme de texte enfoui dans un PDF numérisé.
- POINT D'UTILISATION : Intégration directe avec les outils statistiques. Tout cela est vain si un biostatisticien doit encore exporter, nettoyer et reformater manuellement des données archivées avant de pouvoir les comparer. Ces données archivées doivent pouvoir être intégrées aux chaînes de traitement analytiques telles que R et SAS, qui traitent les données entrantes de l'essai en cours.

Supprimez l'une de ces fonctionnalités et le « temps réel » se réduit à un processus de réconciliation ad hoc et manuel : le problème du rétroviseur qui a ouvert cette série de blogs, mais exécuté à une vitesse supérieure.
Si vous travaillez dans la gestion des données cliniques ou la biostatistique : dans quelle mesure les données historiques des essais de votre organisation sont-elles réutilisables, harmonisables et comparables par une personne extérieure à l’équipe de recherche d’origine, ou utilisables uniquement par les personnes qui les ont créées ?
Prochain article de cette série : la deuxième dimension – comment les mêmes données archivées deviennent des données d’entraînement pour les modèles d’IA/ML, et non plus seulement des comparateurs historiques.
FAQ
Comment les données archivées des essais cliniques peuvent-elles accélérer le développement des médicaments ?
Les données archivées des essais cliniques peuvent accélérer le développement des médicaments en fournissant des données historiques réutilisables au niveau du patient pour la conception des essais, les groupes témoins externes, les comparaisons et l'analyse, réduisant ainsi le besoin de recréer des données ou de recruter de nouveaux groupes témoins.
Pourquoi les données archivées des essais cliniques deviennent-elles un atout stratégique ?
Les données archivées des essais cliniques deviennent un atout stratégique lorsqu'elles sont structurées, harmonisées, consultables et réutilisables pour de nouvelles recherches, la conception d'essais, l'analyse réglementaire et les applications d'IA, et non pas simplement conservées à des fins de conformité.
Qu'est-ce qu'un groupe témoin externe dans un essai clinique ?
Un groupe témoin externe utilise des données provenant de patients extérieurs à l'essai randomisé actuel, telles que des données d'essais cliniques historiques ou des données d'histoire naturelle, pour fournir un groupe de comparaison.
Comment les données historiques des essais cliniques contribuent-elles à réduire la durée de ces essais ?
Les données historiques peuvent réduire les délais en facilitant la conception des essais, en aidant les chercheurs à identifier des populations de patients comparables et, dans certains cas, en réduisant la nécessité de recruter un nouveau groupe témoin.
Qu’est-ce qui rend les données archivées des essais cliniques réutilisables ?
Les données réutilisables des essais cliniques nécessitent un stockage structuré, des modèles de données standardisés, des métadonnées riches, une terminologie cohérente, la dépersonnalisation au niveau du patient, la traçabilité des données, une gouvernance et un accès direct aux outils analytiques.
Pourquoi l'harmonisation des données des essais cliniques est-elle importante ?
L'harmonisation permet de mettre en correspondance les données de différents essais cliniques avec des structures et une terminologie communes, facilitant ainsi la comparaison et l'analyse des populations de patients entre les études.
Quel rôle jouent les métadonnées dans la réutilisation des données des essais cliniques ?
Les métadonnées fournissent un contexte sur les données, notamment les versions des protocoles, les sites, les populations analysées, les essais, la provenance et d'autres informations nécessaires pour déterminer si les données historiques peuvent être réutilisées de manière fiable.
Comment les données historiques des essais cliniques peuvent-elles étayer les essais cliniques en temps réel ?
Les données historiques peuvent fournir une référence structurée pour comparer les données des essais en cours avec les schémas de sécurité antérieurs, les populations de patients, les informations sur la relation dose-réponse et les résultats des essais.
Quels obstacles empêchent les organisations de réutiliser les données archivées des essais cliniques ?
Les difficultés courantes comprennent les référentiels cloisonnés, les modèles de données incohérents, la terminologie héritée, les métadonnées de mauvaise qualité, la difficulté de récupération, la traçabilité incomplète, les limitations de gouvernance et la préparation manuelle des données.
Quelle est la différence entre stocker des données d'essais cliniques et les rendre réutilisables ?
Le stockage des données les préserve pour un accès ultérieur, tandis que les données réutilisables sont structurées, consultables, harmonisées, gouvernées et prêtes à servir de support à l'analyse, à la recherche et à l'utilisation réglementaire.
Références
- CASRAI, « Projet pilote 2026 de la FDA sur les essais cliniques en temps réel (RTCT) : Où en sont les essais en temps réel ? » casrai.org/news/fda-real-time-clinical-trials-rtct-pilot-2026
- Essais cliniques appliqués, « Le HHS lance l'opération TrialBlazer pour rétablir le leadership américain dans la recherche clinique » — appliedclinicaltrialsonline.com/view/hhs-operation-trialblazer-us-leadership-clinical-research
- Arnold et Porter, « La FDA propose un programme pilote accéléré pour les nouveaux médicaments expérimentaux afin de stimuler la recherche clinique de phase précoce aux États-Unis » — arnoldporter.com/en/perspectives/advisories/2026/06/fda-proposes-expedited-investigational-new-drug-pilot-program
- Clinical Trials Arena, « Groupes témoins externes : quand les données historiques peuvent-elles remplacer les placebos ? » clinicaltrialsarena.com/features/external-control-arms
- STAT News, « Les groupes témoins synthétiques constituent une bonne option pour certains essais cliniques » — statnews.com/2019/02/05/essais cliniques sur les bras de contrôle synthétiques
- Agence américaine des produits alimentaires et médicamenteux (FDA), « Mesures prises par la FDA pour accélérer et moderniser le développement clinique précoce et tardif » — fda.gov/industry/fda-actions-accelerate-and-modernize-early-and-late-stage-clinical-development
#EssaisCliniques #GestionDesDonnéesCliniques #ArchivageDesDonnées #SciencesDeLaVie #DonnéesEnVieRéelle #OpérationsCliniques #DéveloppementDeMédicaments #StratégieDesDonnées

Murali Krishnam
Vice-président – Stratégie produit, IA pour l'industrie pharmaceutique
AVERTISSEMENT : LE CONTENU, LES POINTS DE VUE ET LES OPINIONS EXPRIMÉS DANS CE BLOG SONT LA RESPONSABILITÉ EXCLUSIVE DES AUTEURS ET NE REFLÈTENT PAS LA POLITIQUE OU LA POSITION OFFICIELLE DE SOLIX TECHNOLOGIES, INC., DE SES SOCIÉTÉS AFFILIÉES OU DE SES PARTENAIRES. CE BLOG EST EXPLOITÉ DE MANIÈRE INDÉPENDANTE ET N'EST NI RÉVISÉ NI APPROUVÉ PAR SOLIX TECHNOLOGIES, INC. À TITRE OFFICIEL. TOUTES LES MARQUES, LOGOS ET DOCUMENTS PROTÉGÉS PAR LE DROIT D'AUTEUR TIERS MENTIONNÉS DANS CE BLOG APPARTIENNENT À LEURS PROPRIÉTAIRES RESPECTIFS. TOUTE UTILISATION EST STRICTEMENT À DES FINS D'IDENTIFICATION, DE COMMENTAIRE OU ÉDUCATIVES CONFORMÉMENT À LA DOCTRINE DE L'US FAIR USE (US COPYRIGHT ACT § 107 ET ÉQUIVALENTS INTERNATIONAUX). AUCUN PARRAINAGE, AUCUNE APPROBATION OU AFFILIATION AVEC SOLIX TECHNOLOGIES, INC. N'EST IMPLICITE. LE CONTENU EST FOURNI « EN L'ÉTAT », SANS GARANTIE D'EXACTITUDE, D'EXHAUSTIVITÉ OU D'ADÉQUATION À UN USAGE PARTICULIER. SOLIX TECHNOLOGIES, INC. DÉCLINE TOUTE RESPONSABILITÉ POUR LES ACTIONS PRISES SUR LA BASE DE CE MATÉRIEL. LES LECTEURS ASSUMENT L'ENTIÈRE RESPONSABILITÉ DE LEUR UTILISATION DE CES INFORMATIONS. SOLIX RESPECTE LES DROITS DE PROPRIÉTÉ INTELLECTUELLE. POUR SOUMETTRE UNE DEMANDE DE RETRAIT DMCA, ENVOYEZ UN E-MAIL À INFO@SOLIX.COM AVEC : (1) L'IDENTIFICATION DE L'ŒUVRE, (2) L'URL DU MATÉRIEL CONTREFAÇANT, (3) VOS COORDONNÉES ET (4) UNE DÉCLARATION DE BONNE FOI. TOUTE RÉCLAMATION VALIDE RECEVRA UNE EXAMEN RAPIDE. EN ACCÉDANT À CE BLOG, VOUS ACCEPTEZ CET AVIS DE NON-RESPONSABILITÉ ET NOS CONDITIONS D'UTILISATION. CE CONTRAT EST RÉGI PAR LES LOIS DE LA CALIFORNIE.
-
 Publication
Architecture de l'information d'entreprise pour l'IA générale et l'apprentissage automatique
Télécharger le livre blanc -
-
-
 Publication
Intelligence d'entreprise : construire les bases du succès de l'IA
Télécharger le livre blanc