ARCHIVIAZIONE DEI DATI DEGLI STUDI CLINICI — PARTE 5/5
La prima parte di questa serie ha trattato il passaggio da centro di costo ad asset strategico. La seconda parte ha visto come i dati retrospettivi si trasformano in dati di addestramento per l'IA. La terza parte ha visto come l'onere dell'archiviazione derivante da fusioni e acquisizioni si trasforma in un vantaggio unificato. La quarta parte ha visto come i silos applicativi diventano una reale interoperabilità. Questo post riguarda la quinta e ultima dimensione: cosa succede quando qualcuno deve effettivamente recuperare rapidamente i dati di un intero studio per rispondere a una domanda complessa.
All'inizio di quest'anno, la FDA ha chiesto alle case farmaceutiche di rimuovere l'avvertenza relativa ai pensieri suicidari da tre farmaci dimagranti a base di GLP-1: Saxenda, Wegovy e Zepbound. Tale richiesta è seguita a una revisione iniziata nel luglio 2023, quando l'agenzia ha ricevuto le prime segnalazioni di un possibile collegamento. L'analisi finale ha aggregato 91 studi controllati con placebo che hanno coinvolto 107,910 pazienti, oltre a uno studio separato condotto nella pratica clinica su oltre 2.2 milioni di pazienti. La conclusione: nessun aumento del rischio. L'avvertenza è stata rimossa.
Leggendo tra le righe, la vera storia non è la scoperta in sé, ma il percorso che ha portato a tale scoperta. Alcuni di questi 91 studi risalgono alla metà degli anni 2000, condotti con protocolli diversi da team differenti, ben prima che qualcuno si ponesse questa specifica domanda. Rispondere a tale quesito ha significato estrarre i dati a livello di singolo paziente da ciascuno di questi studi e aggregarli in un unico dataset. Non si tratta di una semplice ricerca, ma di un problema di recupero dati, a livello dell'intero studio, non di un singolo campo o modulo.
La maggior parte dei sistemi di ricerca di dati clinici non è ancora progettata per questo scopo. È strutturata a livello di applicazione: si accede all'EDC per verificare un dato, all'eTMF per un altro, a un database sulla sicurezza per un terzo. Ogni singola ricerca è veloce, ma è nell'integrazione di tutti questi dati in un unico record di studio completo e affidabile che si perde tempo prezioso.
Quel tempo ha un costo reale, e non è poco. Nell'ambito della ricerca biomedica in generale, un'analisi economica ampiamente citata ha stimato il costo annuale della ricerca preclinica non riproducibile negli Stati Uniti a circa 28 miliardi di dollari, gran parte dei quali non verificabili o ricostruibili a partire dai dati registrati. Gli studi clinici sono condotti con maggiore rigore rispetto alla ricerca preclinica, ma il problema di fondo rimane lo stesso: i dati che sono tecnicamente conservati da qualche parte non sono la stessa cosa dei dati effettivamente recuperabili, completi e pronti per essere rianalizzati.
Esiste un nome per questo tipo di dati "recuperabili": il modello di dati dei risultati dell'analisi (ARDM) . Invece di fermarsi ai dati grezzi, tratta l'output dell'analisi stessa: le tabelle, le statistiche e le figure prodotte da uno studio come dati strutturati, leggibili automaticamente e riutilizzabili, non come un PDF statico che nessuno può interrogare. L'idea è " scrivi una volta, pronto all'infinito ": un risultato calcolato per uno scopo rimane recuperabile per il successivo, invece di essere bloccato in un documento e ricalcolato da zero ogni volta che qualcuno ne ha bisogno.
I quattro esempi seguenti dimostrano che è impossibile liquidare il divario di recupero come un singolo tentativo andato male.
Uno studio, 2026. Un team ha riprodotto i risultati di uno studio clinico già pubblicato. L'operazione ha richiesto diverse centinaia di ore di lavoro distribuite su cinque team distinti: il dizionario dei dati originale non è stato trovato e i valori statistici necessari per riprodurre i risultati non sono mai stati registrati. Non perché i dati non esistessero, ma perché il collegamento al protocollo dello studio era interrotto. La conclusione dell'articolo: senza l'intero pacchetto di studio, che include protocollo, dizionario e metodi, il riutilizzo è pressoché impossibile.
Replicazione nel mondo reale , 2019. I ricercatori hanno tentato di replicare 220 studi clinici statunitensi pubblicati su riviste ad alto impatto utilizzando dati reali (cartelle cliniche elettroniche e richieste di rimborso assicurativo), riuscendo a replicarne solo 33, pari al 15%. La maggior parte dei fallimenti è riconducibile alla stessa causa principale che questa serie di studi continua a evidenziare: l'intervento, i criteri di ammissibilità o l'endpoint non erano registrati in un formato strutturato e recuperabile al di fuori dei sistemi dello studio originale.
Terapia intensiva, 2018. Una revisione sistematica di 158 pratiche cliniche derivanti da studi in terapia intensiva ha rilevato che solo per 66 di esse (il 42%) è stato effettuato un tentativo di riproduzione. Di queste, il 56% ha prodotto risultati incoerenti con lo studio originale. Due pratiche inizialmente giudicate sicure ed efficaci si sono poi rivelate dannose dopo un'adeguata revisione; la rianimazione con fluidi a base di idrossietilamido ha mostrato le prove più consistenti di danno. In media, sono trascorsi 4.6 anni prima che qualcuno tentasse di effettuare una verifica.
Revisioni sistematiche, 2016. La ricerca stessa spesso non era riproducibile. Una revisione di 272 revisioni sistematiche pubblicate su 25 riviste ha rilevato che solo il 13% riportava una strategia di ricerca sufficientemente dettagliata da poter essere riprodotta in tutti i database utilizzati. I termini di ricerca venivano riportati nel 91% dei casi, ma non sempre veniva specificato a quale database fossero stati applicati e quando la ricerca fosse stata effettivamente eseguita.
E non si tratta solo di recupero dati: ciò che viene riportato può discostarsi da quanto prestabilito. Un'analisi separata delle registrazioni degli studi clinici ha rilevato una discrepanza media del 31% tra i risultati primari registrati e quelli pubblicati, che sale al 100% in alcuni studi, e una discrepanza media del 54% per i risultati secondari. Quando i risultati sono cambiati a posteriori, circa la metà delle volte hanno favorito un risultato statisticamente significativo.
Ecco perché sia l'industria che la regolamentazione si stanno orientando verso il recupero dei dati a livello di studio, non a livello di singola applicazione. L'EMA richiede la pubblicazione proattiva di report completi degli studi clinici sin dall'entrata in vigore della sua Policy 0070 nel 2016, non solo di risultati riassuntivi. Gli editori delle riviste, tramite l'ICMJE, richiedono un piano di condivisione dei dati per gli studi clinici dal 2018. Piattaforme senza scopo di lucro come Vivli esistono proprio per consentire ai ricercatori di richiedere dati completi dello studio, non documenti sparsi provenienti da diversi sistemi. Nulla di tutto ciò funziona se "lo studio" esiste solo come frammenti di dati sparsi in applicazioni scollegate.
I 5 requisiti fondamentali per il recupero di informazioni a livello di studio:
- Un unico ID persistente per l'intero studioNon un ID per ogni documento o set di dati, ma un ID che collega il protocollo, i dati dello studio, il codice di analisi e il rapporto dello studio clinico (CSR) in un'unica unità recuperabile.
- Un pacchetto completo, non solo il set di dati.La rianalisi del 2026, basata su un singolo studio, rappresenta un monito: i dati grezzi, senza il protocollo, il dizionario e i metodi di analisi, non sono riutilizzabili. Il modello di dati dei risultati dell'analisi (ARDM) va oltre.
- Un'unica query gestita anziché cinque accessi separati.Un ricercatore o un ente regolatore deve poter scaricare un intero studio in un'unica operazione, non ricostruirlo a partire dall'EDC, dall'eTMF e da un archivio di statistiche.
- Metodologia documentata, fino al numero di seme.La riproducibilità esatta a questo livello di dettaglio dipende dagli elementi specifici. Se un dato non viene rilevato in quel momento, non può essere recuperato in seguito.
- Gli studi vecchi e nuovi sono reperibili allo stesso modoLa revisione del GLP-1 necessitava di studi clinici risalenti alla metà degli anni 2000 da combinare con quelli degli anni 2020. Un sistema di recupero dati che funziona solo per gli studi degli anni precedenti non è affatto un sistema di recupero dati: è solo una comodità temporanea.
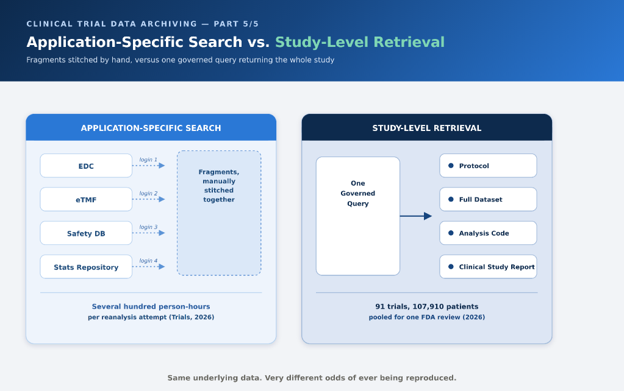
La revisione della sicurezza del GLP-1 rappresenta la versione positiva di questa storia. Rispondere alla domanda "esiste davvero un rischio di suicidio?" ha richiesto di considerare decenni di studi su Saxenda, condotti ben prima che questa domanda venisse posta, come dati recuperabili e aggregabili, insieme ai più recenti studi su Wegovy e Zepbound. Ciò è possibile solo se l'intera documentazione di uno studio è conservata come un pacchetto coerente e recuperabile, e non come una cartella di file che si sono casualmente salvati nel sistema che li ha creati. Grazie a ciò, l'agenzia ha potuto aggregare i dati di 91 studi e risolvere un importante quesito di sicurezza con dati reali anziché con supposizioni: il risultato è stato la rimozione di un'avvertenza, non un peggioramento dell'etichetta.
Tutto ciò che è presente in questo elenco rappresenta in realtà i principi FAIR introdotti in questa serie nella Parte 3, applicati a livello di studio anziché al singolo caso:
- trovabiliOgni studio possiede un ID univoco e permanente, anziché ID di documento sparsi in sistemi separati.
- AccessibileUn processo di recupero controllato restituisce l'intero studio su richiesta, anziché una ricerca manuale tra i vari sistemi.
- Interoperabile. Studi vecchi e nuovi utilizzano una struttura che consente loro di essere inclusi nella stessa analisi aggregata senza bisogno di un progetto di traduzione.
- RiutilizzabileIl protocollo, il dizionario dei dati, i metodi di analisi e i risultati viaggiano insieme, quindi la rianalisi non dipende dal ricordare dettagli che nessuno ha annotato.
Saltando anche solo una di queste opzioni, il recupero dei dati a livello di studio torna silenziosamente alla ricerca specifica per l'applicazione, che è tecnicamente possibile, ma praticamente lenta e può portare a risultati non riproducibili con un solo link non funzionante.
Questo conclude la serie di articoli del blog, quindi vale la pena indicarne chiaramente il filo conduttore. Ogni articolo sembrava affrontare un problema diverso: giustificazione dei costi, rilevanza dell'IA, vantaggi derivanti da fusioni e acquisizioni, proliferazione delle applicazioni, risultati del recupero dei dati . In realtà, ognuno di essi si poneva la stessa domanda, da un'angolazione diversa: i vostri dati sono gestiti in modo sufficientemente efficace da poter essere trovati, considerati affidabili e riutilizzati da chi non era presente al momento della loro creazione?
- Dimensione 1 - Centro di costo trasformato in risorsa strategicaI dati degli studi clinici archiviati, se riutilizzati correttamente, ridurranno i tempi di sviluppo.
- Dimensione 2 - Specchietto retrovisore per i dati di addestramentoQuesto stesso archivio costituisce la materia prima per i modelli di intelligenza artificiale, a condizione che la sua provenienza sia documentata con la stessa rigorosità del modello stesso.
- Dimensione 3 - L'onere dell'archiviazione per il vantaggio unificatoLe fusioni e acquisizioni moltiplicano gli archivi; i principi FAIR sono ciò che permetterà ai dati di due aziende di diventare un'unica risorsa utilizzabile, anziché due schedari separati.
- Dimensione 4 - Dalla trasformazione dei silos applicativi alla reale interoperabilità.Le applicazioni "best-of-breed" possono coesistere con una reale interoperabilità, ma solo se al di sotto di esse si trova un livello dati comune e governato.
- Dimensione 5 — Ricerca specifica per applicazione per il recupero a livello di studioTutto quanto detto finora si rivela utile solo se l'intero studio può essere effettivamente recuperato, completo e riproducibile, quando necessario.
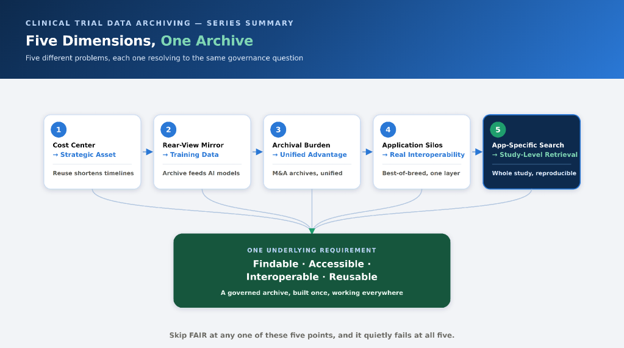
Cinque problemi distinti, un unico requisito fondamentale: dati reperibili, accessibili, interoperabili e riutilizzabili, sia per l'intelligenza artificiale, sia per le fusioni e acquisizioni, sia per le applicazioni che li generano, sia per il momento in cui qualcuno deve riprodurre l'intero studio.
Nessuna di queste cinque dimensioni è opzionale di per sé, e nessuna di esse funziona isolatamente. Un archivio economico da creare e riutilizzare, ma incapace di alimentare un modello di intelligenza artificiale, di unificarsi dopo un'acquisizione, di sopravvivere in un ambiente applicativo multi-vendor o di essere recuperato integralmente sotto pressione normativa, non è effettivamente completo. Il principio FAIR non si è mai concentrato su uno solo di questi cinque problemi, ma su tutti insieme.
Se anche la vostra organizzazione sta applicando l'IA a questo tipo di problema nelle fasi iniziali del processo, vale la pena dare un'occhiata al white paper dei miei colleghi Rohit Pardeshi e Soumith Babbari : delinea un framework per l'utilizzo di infrastrutture di dati connesse per accelerare il riposizionamento dei farmaci e l'identificazione dei target basati sull'IA. Si tratta della stessa logica "studio completo, non solo di un campo" che questo blog sostiene, applicata alla decisione su cosa ricercare in futuro, piuttosto che a come difendere ciò che è già stato studiato. A Framework for AI-Driven Drug Repurposing and Target Identification in Pharma R&D.
Se lavorate nel campo della biostatistica, degli affari regolatori o della gestione dei dati: se domani un ente regolatore chiedesse alla vostra organizzazione di raccogliere tutti i dati relativi a uno studio su un determinato prodotto risalenti a quindici anni fa, recuperereste l'intero studio o lo ricostruireste, una richiesta alla volta?
DOMANDE FREQUENTI
Che cos'è il recupero a livello di studio nella gestione dei dati delle sperimentazioni cliniche?
Il recupero a livello di studio significa recuperare uno studio clinico completo come un pacchetto unico, gestito e affidabile, anziché cercare singoli record in applicazioni separate. Collega il protocollo, i dati dello studio, i metodi di analisi e il rapporto dello studio clinico, in modo che lo studio possa essere recuperato e riutilizzato nella sua interezza.
Qual è la differenza tra ricerca specifica per applicazione e ricerca a livello di studio?
La ricerca specifica per applicazione recupera le informazioni un sistema alla volta, come ad esempio un EDC, un eTMF o un database sulla sicurezza. Il recupero a livello di studio fornisce lo studio completo tramite un'unica richiesta gestita, riducendo la necessità di ricostruire manualmente le informazioni da più sistemi non collegati.
Perché il recupero dei dati a livello di studio è importante per le sperimentazioni cliniche?
Il recupero a livello di studio semplifica la ricerca, l'accesso, l'analisi, la riproduzione e il riutilizzo dei dati delle sperimentazioni cliniche. Conservare i soli dati non è sufficiente; anche il protocollo associato, il dizionario dei dati, la metodologia e i risultati devono rimanere reperibili e collegati.
Quali elementi dovrebbero essere inclusi in un pacchetto completo di dati di una sperimentazione clinica?
Un pacchetto completo per uno studio clinico dovrebbe includere il protocollo di studio, i dati dello studio, il dizionario dei dati, il codice o i metodi di analisi e il rapporto dello studio clinico. Questi componenti forniscono il contesto necessario per comprendere, riprodurre e riutilizzare lo studio, anziché basarsi esclusivamente sui dati grezzi.
Che cos'è il modello di dati dei risultati dell'analisi (ARDM)?
Il modello di dati dei risultati dell'analisi (ARDM) tratta gli output dell'analisi, come tabelle, statistiche e figure, come dati strutturati, leggibili automaticamente e riutilizzabili, anziché come documenti statici. Questo approccio contribuisce a rendere i risultati dell'analisi recuperabili per un utilizzo futuro senza la necessità di ricalcolarli da zero.
In che modo il recupero di dati a livello di studio supporta la riproducibilità delle sperimentazioni cliniche?
Il recupero a livello di studio favorisce la riproducibilità mantenendo insieme le informazioni necessarie per riprodurre uno studio. Ciò include il protocollo, il dizionario dei dati, i metodi di analisi e altri dettagli metodologici, comprese informazioni precise come i numeri di riferimento statistici, ove richiesto.
Quali sono i cinque requisiti fondamentali per il recupero di informazioni a livello di studio?
I cinque requisiti fondamentali sono: un unico ID permanente per l'intero studio, un pacchetto di studio completo, una query gestita in modo centralizzato anziché ricerche multiple nelle applicazioni, una metodologia documentata e un recupero coerente sia degli studi storici che di quelli nuovi.
In che modo i principi FAIR si applicano al recupero dei dati degli studi clinici?
I principi FAIR rendono i dati degli studi clinici reperibili, accessibili, interoperabili e riutilizzabili. A livello di studio, ciò significa utilizzare identificativi di studio persistenti, un recupero controllato, strutture compatibili e mantenere insieme protocollo, dati, metodi e risultati.
In che modo il recupero di dati a livello di studio supporta la revisione normativa e l'analisi della sicurezza?
Il recupero dei dati a livello di studio consente a ricercatori e autorità di regolamentazione di accedere e aggregare i dati completi degli studi clinici quando si indagano su importanti questioni di sicurezza o regolatorie. La revisione della sicurezza del GLP-1 illustra come è possibile recuperare studi precedenti e combinarli con studi più recenti per rispondere a una specifica domanda di sicurezza.
Perché i vecchi studi clinici dovrebbero essere recuperabili utilizzando lo stesso approccio dei nuovi studi?
Per scopi di revisione normativa, analisi della sicurezza o ricerca, potrebbe essere necessario combinare studi storici con studi più recenti. Un sistema di recupero dati dovrebbe pertanto rendere accessibili sia gli studi vecchi che quelli nuovi attraverso lo stesso approccio strutturato, anziché limitare il recupero ai soli dati creati di recente.
Referenze
- FDA statunitense, "La FDA richiede la rimozione dell'avvertenza relativa al comportamento e all'ideazione suicidaria dai farmaci agonisti del recettore GLP-1" (aprile 2026) — fda.gov/drugs/drug-safety-communications/fda-requests-removal-suicidal-behavior-and-ideation-warning-glucagon-peptide-1-receptor-agonist-glp
- Science News, "La ricerca non riproducibile nel campo delle scienze biologiche negli Stati Uniti costa 28 miliardi di dollari", articolo basato su Freedman, Cockburn e Simcoe, "L'economia della riproducibilità nella ricerca preclinica", PLOS Biology (2015) — sciencenews.org/article/irreproducible-life-sciences-research-us-costs-28-billion
- Kirchner et al., "Ripensare i dati degli studi clinici: perché dovremmo rispettare i risultati delle analisi come dati", Scientific Data (2022) — nature.com/articles/s41597-022-01789-2
- Ansari et al., "La riproducibilità delle strategie di ricerca è scarsa nelle revisioni sistematiche pubblicate su riviste di pediatria, cardiologia e chirurgia ad alto impatto", PLOS One (2016) — journals.plos.org/plosone/article?id=10.1371/journal.pone.0163309
- Sperimentazioni (Springer Nature), "Supporto alla rianalisi e al riutilizzo dei dati delle sperimentazioni cliniche: un caso di studio" (2026) — link.springer.com/article/10.1186/s13063-026-09646-y
- Niven et al., "Riproducibilità della ricerca clinica in terapia intensiva: una revisione esplorativa", BMC Medicine (2018) — link.springer.com/article/10.1186/s12916-018-1018-6
- Franklin et al., "Fattibilità dell'utilizzo di dati del mondo reale per replicare le evidenze degli studi clinici", JAMA Network Open (2020) — jamanetwork.com/journals/jamanetworkopen/fullarticle/2752575
- Jones et al., "Confronto tra i risultati registrati e pubblicati negli studi clinici randomizzati controllati: una revisione sistematica", BMC Medicine (2015) — link.springer.com/article/10.1186/s12916-015-0520-3
- New England Journal of Medicine, “Trasparenza e Agenzia europea per i medicinali: condivisione dei dati delle sperimentazioni cliniche” (2015) — nejm.org/doi/full/10.1056/NEJMp1409464
- Wilkinson et al., “I principi guida FAIR per la gestione e la custodia dei dati scientifici”, Scientific Data (2016) — nature.com/articles/sdata201618
- Vivli, piattaforma globale senza scopo di lucro per la condivisione di dati sulla ricerca clinica — vivli.org
#SperimentazioniCliniche #GestioneDatiClinici #ScienzeDellaVita #Riproducibilità #DatiFAIR #StrategiaDeiDati #SviluppoFarmaci #AffariRegolatori

Murali Krishnam
Vicepresidente - Strategia di prodotto, Intelligenza artificiale per il settore farmaceutico aziendale
ESCLUSIONE DI RESPONSABILITÀ: I CONTENUTI, LE OPINIONI E I PUNTI DI VISTA ESPRESSI IN QUESTO BLOG SONO ESCLUSIVAMENTE DELL'AUTORE/DEGLI AUTORI E NON RIFLETTONO LA POLITICA O LA POSIZIONE UFFICIALE DI SOLIX TECHNOLOGIES, INC., DELLE SUE AFFILIATE O DEI SUOI PARTNER. QUESTO BLOG È GESTITO IN MODO INDIPENDENTE E NON È REVISIONATO O APPROVATO DA SOLIX TECHNOLOGIES, INC. IN QUALIFICA UFFICIALE. TUTTI I MARCHI, I LOGHI E I MATERIALI PROTETTI DA COPYRIGHT DI TERZE PARTI QUI RIFERITI SONO DI PROPRIETÀ DEI RISPETTIVI TITOLARI. QUALSIASI UTILIZZO È RIGOROSAMENTE A SCOPO IDENTIFICATIVO, DI COMMENTO O DIDATTICO, AI SENSI DELLA DOTTRINA DEL FAIR USE (STATI UNITI COPYRIGHT ACT § 107 E EQUIVALENTI INTERNAZIONALI). NON È IMPLICITA ALCUNA SPONSORIZZAZIONE, APPROVAZIONE O AFFILIAZIONE CON SOLIX TECHNOLOGIES, INC. IL CONTENUTO VIENE FORNITO "COSÌ COM'È" SENZA GARANZIE DI ACCURATEZZA, COMPLETEZZA O IDONEITÀ PER QUALSIASI SCOPO. SOLIX TECHNOLOGIES, INC. DECLINA OGNI RESPONSABILITÀ PER AZIONI INTRAPRESE IN BASE A QUESTO MATERIALE. I LETTORI SI ASSUMONO LA PIENA RESPONSABILITÀ PER L'UTILIZZO DI QUESTE INFORMAZIONI. SOLIX RISPETTA I DIRITTI DI PROPRIETÀ INTELLETTUALE. PER PRESENTARE UNA RICHIESTA DI RIMOZIONE DMCA, INVIARE UN'E-MAIL A INFO@SOLIX.COM CON: (1) IDENTIFICAZIONE DELL'OPERA, (2) L'URL DEL MATERIALE CHE VIOLA, (3) I PROPRI DATI DI CONTATTO E (4) UNA DICHIARAZIONE DI BUONA FEDE. I RECLAMI VALIDI RICEVERANNO IMMEDIATA ATTENZIONE. ACCEDENDO A QUESTO BLOG, ACCETTI LA PRESENTE ESCLUSIONE DI RESPONSABILITÀ E I NOSTRI TERMINI DI UTILIZZO. IL PRESENTE CONTRATTO È REGOLATO DALLE LEGGI DELLA CALIFORNIA.
-
 White Paper
Architettura delle informazioni aziendali per Gen AI e Machine Learning
Scarica carta bianca -
-
-
 White Paper
Enterprise Intelligence: costruire le basi per il successo dell'intelligenza artificiale
Scarica carta bianca