La conversazione che la maggior parte dei programmi di intelligenza artificiale non sta avendo
Le organizzazioni che passano da un progetto pilota di IA a un programma di IA condividono un elemento comune: hanno risolto la questione architetturale prima che la scalabilità la rivelasse. Hanno definito la struttura di base dei dati – in termini di proprietà di archiviazione, livelli semantici e controlli delle pipeline – prima di implementare la seconda o la terza applicazione in produzione.
La maggior parte non segue questa sequenza. Si sceglie il modello. Si definiscono i casi d'uso. Si realizzano i prototipi. E la base dati viene considerata come qualcosa che verrà affrontato man mano che il programma cresce. Negli ambienti aziendali, questa ipotesi è costantemente la causa del ritardo – e dei costi – quando si tenta finalmente di scalare il progetto.
Accessibile non è sinonimo di pronto per l'IA
La distinzione che spesso viene trascurata nelle fasi iniziali della pianificazione dei programmi di intelligenza artificiale è quella tra dati accessibili e dati pronti per l'IA.
I dati accessibili possono essere interrogati . Esistono in un sistema, possono essere estratti e un modello può utilizzarli. La maggior parte dei dati aziendali soddisfa questa soglia. I dati pronti per l'IA sono gestiti fin dal momento dell'acquisizione, possiedono un significato semantico verificato, sono stati validati in termini di qualità prima di essere utilizzati in un modello e possono essere tracciati dalla fonte alla risposta senza interruzioni nella loro provenienza.
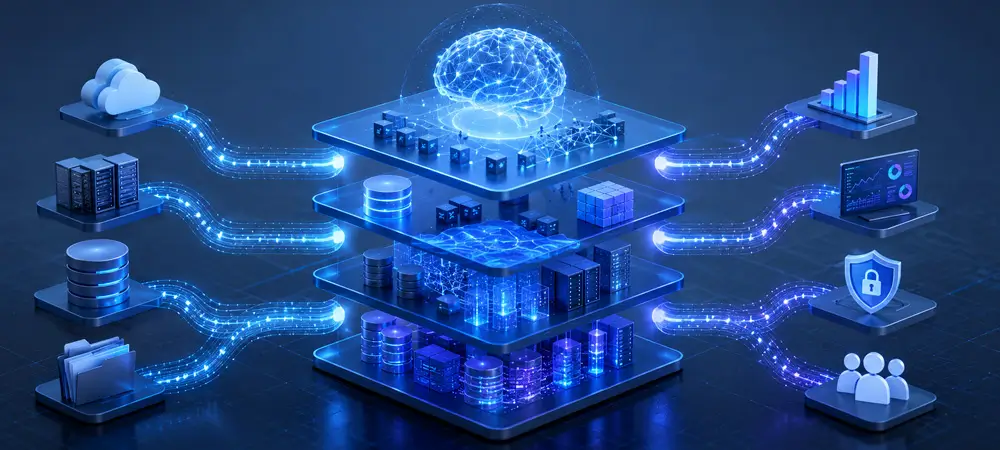
La differenza tra queste due definizioni è di natura architettonica, non riguarda un progetto di qualità dei dati. Non è possibile gestire i dati retroattivamente alla scala richiesta dall'IA aziendale. I tre livelli che determinano la scalabilità dell'IA aziendale – archiviazione, metadati e pipeline – svolgono ciascuno un ruolo distinto e ognuno crea le condizioni da cui dipende il livello successivo.
Perché le fondamenta sono sempre l'ultima cosa che si costruisce
La maggior parte degli ambienti dati aziendali non è stata progettata pensando all'intelligenza artificiale. I dati finiscono in sistemi di archiviazione creati per l'elaborazione delle transazioni. I metadati, se esistono, sono documentati in fogli di calcolo, nascosti in dizionari di dati o custoditi nella mente degli ingegneri che hanno progettato i sistemi originali. Le pipeline sono costruzioni ad hoc, mai progettate per alimentare un'applicazione di intelligenza artificiale in produzione su larga scala.
Il risultato: ogni iniziativa di IA parte di fatto da zero a livello di dati. I controlli di qualità vengono applicati in modo incoerente. La governance viene aggiunta a posteriori. Le piattaforme di machine learning generiche forniscono strumenti per lo sviluppo di modelli, ma non l'acquisizione governata, il livello semantico o i controlli di qualità di livello produttivo che rendono tali strumenti affidabili sui dati aziendali reali. I clienti costruiscono questi livelli autonomamente, ed è per questo che le iniziative di IA richiedono costantemente più tempo e costano di più rispetto a quanto previsto inizialmente dal business case.
Tre livelli, tre compiti distinti
Il livello di storage è il punto di partenza della governance, o dove questa viene permanentemente posticipata. Le transazioni ACID , l'evoluzione dello schema e le query di viaggio nel tempo non sono caratteristiche prestazionali, bensì requisiti di governance. L'evoluzione dello schema è fondamentale perché i sistemi sorgente aziendali cambiano continuamente; un livello di storage che non è in grado di assorbire tali cambiamenti diventa un collo di bottiglia per ogni iniziativa di intelligenza artificiale a un livello superiore. Le query di viaggio nel tempo consentono alle aziende soggette a normative di rispondere a quesiti di audit storici senza dover ricostruire manualmente i dati. La conservazione imposta al momento dell'acquisizione elimina un'intera classe di rischio di conformità che la maggior parte delle organizzazioni gestisce attualmente tramite processi e documentazione anziché tramite l'architettura. Solix offre tutto questo attraverso un lakehouse governato basato su Apache Hudi e una Preservation Zone dedicata ai dati delle applicazioni aziendali, con funzionalità di conservazione e blocco legale attive dal momento in cui i dati arrivano.
Il livello dei metadati è dove i dati acquisiscono significato e dove, nella maggior parte dei casi, le fondamenta dell'IA aziendale sono più deboli. Uno schema di database indica quali campi esistono, ma non cosa rappresentano o come sono correlati tra le applicazioni. Un sistema di IA che ragiona su uno schema grezzo inferisce un significato aziendale che non possiede, producendo output che non possono essere spiegati o ricondotti a una fonte. Un Application Knowledge Graph colma questa lacuna: un livello semantico che codifica gli oggetti aziendali, le relazioni, il vocabolario e i modelli di query testati specifici di un'applicazione aziendale. Solix fornisce Application Knowledge Graph preconfigurati per Oracle EBS , SAP ECC/S4HANA , PeopleSoft e JD Edwards , eliminando dal carico di lavoro del cliente la fase più dispendiosa in termini di tempo della creazione semantica. Per i contenuti non strutturati, un indice semantico creato al momento dell'acquisizione applica lo stesso principio: il significato viene codificato prima che un modello lo elabori. Il risultato sono risposte di IA che possono essere ricondotte a una definizione aziendale certificata e presentate con sicurezza a un ente regolatore o a un consiglio di amministrazione.
Il livello della pipeline è dove viene determinata l'affidabilità di ogni output di IA a valle. La profilazione automatizzata, le regole di qualità, il tracciamento della provenienza dei dati e i flussi di lavoro di preparazione dei dati garantiscono che i problemi vengano individuati in fase di acquisizione, e non dopo che una raccomandazione errata dell'IA ha già influenzato una decisione aziendale. Solix struttura questo processo in quattro fasi sequenziali e controllate: acquisizione, lakehouse controllata, qualità dei dati e flusso di machine learning. Ciascuna fase è verificabile e riduce il tempo che intercorre tra l'arrivo dei dati e la loro disponibilità in produzione per l'IA.
Come si presenta una base pronta per la produzione
Si consideri un'organizzazione di servizi finanziari che consolida i dati di Oracle EBS e SAP insieme a flussi operativi in tempo reale e record archiviati provenienti da applicazioni dismesse. L'obiettivo: una piattaforma di intelligence operativa e di rischio basata sull'intelligenza artificiale, con accesso in linguaggio naturale per gli utenti aziendali e una base strutturata per i team di data science.
A livello di storage, i dati vengono archiviati in un lakehouse governato con transazioni ACID , evoluzione dello schema e query di time-travel per la verifica a fini normativi. I dati delle applicazioni legacy vengono spostati in una Preservation Zone governata , con gestione della conservazione e pronti per la conservazione legale fin dall'arrivo.
A livello di metadati, i Knowledge Graph applicativi preconfigurati per Oracle EBS e SAP vengono adattati alla specifica configurazione dell'organizzazione, codificando i flussi di valore Procure-to-Pay, Order-to-Cash e Record-to-Report. Un catalogo unificato degli asset mantiene definizioni aziendali certificate e la tracciabilità dei dati in tutta l'infrastruttura. Quando un analista aziendale effettua una query in linguaggio naturale o un modello di rischio interroga i dati, la risposta viene ricondotta a una definizione certificata, non a un'inferenza da una tabella grezza.
A livello di pipeline, le regole di qualità vengono attivate prima che i dati raggiungano qualsiasi modello. La tracciabilità monitora ogni elemento dalla sorgente al prodotto pronto per l'IA. Il team di data science lavora su dati gestiti in modo trasparente, non su mesi di ingegneria dei dati personalizzata necessaria prima che il primo modello possa essere addestrato.
Tre domande da porsi prima che la prossima iniziativa sull'IA si espanda su larga scala.
Prima di impegnarsi nella fase successiva di investimento nell'IA, vale la pena porre direttamente al team tre domande sull'architettura dei dati.
I dati vengono acquisiti in un ambiente controllato fin dal primo byte, con convalida della qualità, politiche di conservazione e registri di controllo applicati fin dall'acquisizione, oppure la governance viene applicata a posteriori, quando emerge un problema? Le organizzazioni che non sanno rispondere alla prima domanda corrono un rischio di non conformità che aumenta con ogni applicazione di intelligenza artificiale implementata.
I sistemi di intelligenza artificiale che operano su tali dati possiedono un livello semantico che codifica il significato aziendale, oppure ragionano direttamente su schemi grezzi? Senza un livello semantico, gli output dell'IA non possono essere tracciati, spiegati o difesi in modo affidabile.
Le pipeline che alimentano i modelli di IA producono dati gestiti e tracciabili, oppure input grezzi che ogni nuova iniziativa deve rielaborare autonomamente? Quest'ultima opzione implica sostenere ripetutamente i costi di ingegneria dei dati, una volta per ogni iniziativa anziché una volta per l'intera infrastruttura.
Se rispondere a una qualsiasi di queste domande risulta più difficile del previsto, è proprio da lì che inizia la revisione dell'architettura e dove prende forma il progetto per un'intelligenza artificiale aziendale scalabile.

Stefano Tallant
Vicepresidente del marketing dei prodotti
ESCLUSIONE DI RESPONSABILITÀ: I CONTENUTI, LE OPINIONI E I PUNTI DI VISTA ESPRESSI IN QUESTO BLOG SONO ESCLUSIVAMENTE DELL'AUTORE/DEGLI AUTORI E NON RIFLETTONO LA POLITICA O LA POSIZIONE UFFICIALE DI SOLIX TECHNOLOGIES, INC., DELLE SUE AFFILIATE O DEI SUOI PARTNER. QUESTO BLOG È GESTITO IN MODO INDIPENDENTE E NON È REVISIONATO O APPROVATO DA SOLIX TECHNOLOGIES, INC. IN QUALIFICA UFFICIALE. TUTTI I MARCHI, I LOGHI E I MATERIALI PROTETTI DA COPYRIGHT DI TERZE PARTI QUI RIFERITI SONO DI PROPRIETÀ DEI RISPETTIVI TITOLARI. QUALSIASI UTILIZZO È RIGOROSAMENTE A SCOPO IDENTIFICATIVO, DI COMMENTO O DIDATTICO, AI SENSI DELLA DOTTRINA DEL FAIR USE (STATI UNITI COPYRIGHT ACT § 107 E EQUIVALENTI INTERNAZIONALI). NON È IMPLICITA ALCUNA SPONSORIZZAZIONE, APPROVAZIONE O AFFILIAZIONE CON SOLIX TECHNOLOGIES, INC. IL CONTENUTO VIENE FORNITO "COSÌ COM'È" SENZA GARANZIE DI ACCURATEZZA, COMPLETEZZA O IDONEITÀ PER QUALSIASI SCOPO. SOLIX TECHNOLOGIES, INC. DECLINA OGNI RESPONSABILITÀ PER AZIONI INTRAPRESE IN BASE A QUESTO MATERIALE. I LETTORI SI ASSUMONO LA PIENA RESPONSABILITÀ PER L'UTILIZZO DI QUESTE INFORMAZIONI. SOLIX RISPETTA I DIRITTI DI PROPRIETÀ INTELLETTUALE. PER PRESENTARE UNA RICHIESTA DI RIMOZIONE DMCA, INVIARE UN'E-MAIL A INFO@SOLIX.COM CON: (1) IDENTIFICAZIONE DELL'OPERA, (2) L'URL DEL MATERIALE CHE VIOLA, (3) I PROPRI DATI DI CONTATTO E (4) UNA DICHIARAZIONE DI BUONA FEDE. I RECLAMI VALIDI RICEVERANNO IMMEDIATA ATTENZIONE. ACCEDENDO A QUESTO BLOG, ACCETTI LA PRESENTE ESCLUSIONE DI RESPONSABILITÀ E I NOSTRI TERMINI DI UTILIZZO. IL PRESENTE CONTRATTO È REGOLATO DALLE LEGGI DELLA CALIFORNIA.
-
 White Paper
Architettura delle informazioni aziendali per Gen AI e Machine Learning
Scarica carta bianca -
-
-
 White Paper
Enterprise Intelligence: costruire le basi per il successo dell'intelligenza artificiale
Scarica carta bianca