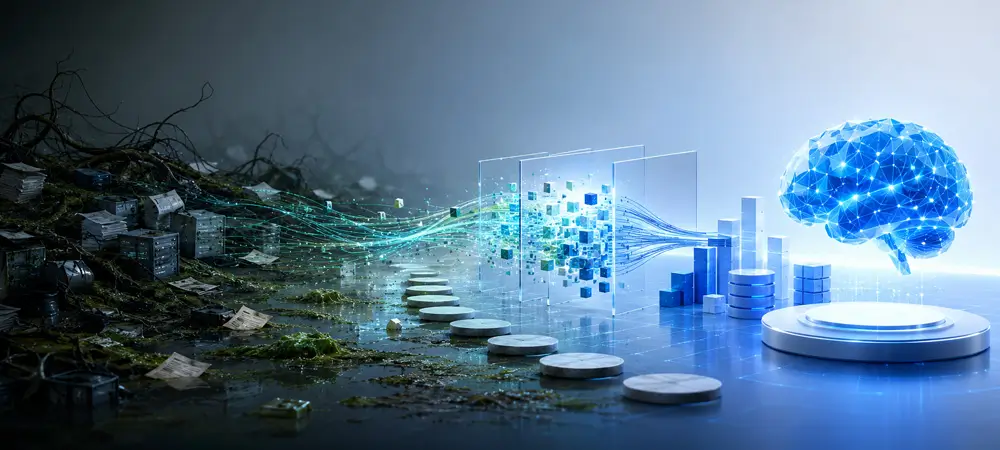
La maggior parte dei dati aziendali non è complessa. Semplicemente, non è regolamentata.
Le organizzazioni descrivono il loro ambiente dati come complesso quando in realtà intendono qualcosa di più preciso: i dati si sono accumulati in sistemi che non sono mai stati progettati per condividerli, le applicazioni obsolete contengono decenni di storia aziendale in formati che il team attuale non ha mai visto, i metadati esistono solo in fogli di calcolo o nella memoria di ingegneri che potrebbero non essere più disponibili, e ogni iniziativa di intelligenza artificiale inizia allo stesso modo: mesi di ingegneria dei dati prima che il primo modello possa essere addestrato.
Non si tratta di complessità, bensì di assenza di governance. E la distinzione è importante perché la complessità implica che il problema sia di natura architetturale, ovvero che richieda nuove piattaforme, nuovi investimenti e nuove infrastrutture. I dati non governati rappresentano invece un problema strutturale, che può essere risolto attraverso una sequenza definita di decisioni, a partire dal momento in cui i dati arrivano.
Tre fasi, una sequenza
Il percorso da una palude di dati a una risorsa pronta per l'IA si articola in tre fasi: ad hoc, gestita e ottimizzata. La maggior parte delle aziende crede di essere più avanti di quanto non sia in realtà. La diagnosi è semplice. Se un'iniziativa di IA richiede mesi di data engineering prima che il primo modello possa essere addestrato, i dati sono ad hoc. Se gli output dell'IA non possono essere ricondotti a una fonte, manca il livello semantico. Se la risposta alla domanda "chi può interrogare questi dati?" è "il team dati, dopo aver aperto un ticket", la fase di ottimizzazione non è stata ancora raggiunta.
Le tre fasi non costituiscono uno spettro, bensì una sequenza. La gestione è un prerequisito per l'ottimizzazione. Le organizzazioni che raggiungono più rapidamente lo stato di ottimizzazione sono quelle che hanno considerato ogni fase come una decisione progettuale, non come un risultato che si accumula per caso.
Fase uno: Ad hoc — Dove risiede la maggior parte dei dati aziendali
Nella fase ad hoc, i dati esistono ma non possono essere utilizzati in modo affidabile. Finiscono in sistemi di archiviazione progettati per l'elaborazione delle transazioni. Le applicazioni dismesse contengono registri finanziari, dati sugli acquisti e transazioni dei clienti – anni o decenni di storia aziendale – ma l'applicazione che forniva il contesto per quei dati è stata dismessa. Ciò che rimane è spesso criptico: nomi di tabelle che avevano un significato per lo sviluppatore originale, convenzioni di colonna ereditate da software scritti in un decennio diverso e relazioni codificate nella logica applicativa anziché nello schema del database.
Il costo viene sostenuto all'inizio di ogni iniziativa di intelligenza artificiale. I team di ingegneria dei dati creano pipeline di acquisizione personalizzate per ogni nuovo progetto. I controlli di qualità sono incoerenti o assenti. La governance – politiche di conservazione, controlli di accesso, classificazione – è documentata da qualche parte, ma non viene applicata nei sistemi in cui i dati risiedono effettivamente. Ogni progetto reinventa le stesse fondamenta. La validità economica dell'investimento in IA viene compromessa ancor prima che venga addestrato il primo modello, perché i dati necessari a tale modello non sono pronti.
Fase due: Gestita — La governance prima dell'intelligence
La fase di gestione inizia con l'acquisizione dei dati. I dati arrivano in un ambiente controllato in cui le politiche di conservazione vengono applicate fin dal primo byte, i controlli di qualità vengono eseguiti prima che i dati raggiungano qualsiasi sistema a valle, i record vengono classificati in base alla tassonomia dell'organizzazione e la funzionalità di blocco legale è attiva dal momento in cui i dati arrivano. Non si tratta di un aggiornamento dello storage. Si tratta di un cambiamento strutturale nel modo in cui i dati vengono ricevuti: un'architettura di Zona di Conservazione che fornisce una sede centralizzata e controllata per i dati provenienti da applicazioni dismesse, sistemi acquisiti e ambienti di produzione attivi, il tutto sotto un unico modello di policy.
Il livello di applicazione risiede nella piattaforma di governance: la conservazione dei dati viene applicata in tempo reale, la mascheratura viene applicata all'accesso e ogni azione di governance viene registrata in una traccia di controllo immutabile. La fase gestita non produce output di intelligenza artificiale. Produce dati sufficientemente affidabili su cui basarsi: dati classificati, validati, governati e legalmente difendibili. Le organizzazioni che raggiungono questa fase hanno risolto il problema della conformità. Ciò che non hanno ancora risolto è il problema del significato.
Fase tre: Ottimizzazione — Quando i dati diventano carburante
I dati gestiti diventano pronti per l'IA quando viene aggiunto un livello semantico. Questa è la transizione che la maggior parte delle piattaforme generiche omette, ed è quella che determina se l'IA opera sulla base di un significato aziendale verificato o di uno schema inferito. Uno schema di database identifica quali campi esistono. Non codifica ciò che rappresentano, come si relazionano tra i flussi di valore su cui si basa l'azienda, né cosa costituisce un modello di query valido nel contesto di quell'applicazione. Un sistema di IA che ragiona su uno schema grezzo sta facendo delle supposizioni. Le risposte che produce non possono essere spiegate, tracciate o considerate affidabili ai fini di una decisione aziendale.
Un Knowledge Graph applicativo colma questa lacuna: codifica gli oggetti aziendali, le relazioni, il vocabolario e i modelli di query testati specifici di un'applicazione aziendale. Solix fornisce Knowledge Graph applicativi preconfigurati per Oracle EBS , SAP ECC/S4HANA , PeopleSoft e JD Edwards , i sistemi ERP che contengono la maggior parte dei dati strutturati aziendali, e crea Knowledge Graph personalizzati tramite un processo di scoperta basato sull'intelligenza artificiale per applicazioni legacy e acquisite per le quali non esiste un equivalente preconfigurato. Per i contenuti non strutturati, Content Intelligence crea il livello semantico su documenti, contratti e record, rendendoli interrogabili insieme ai dati strutturati in un'unica interfaccia gestita.
Grazie al livello semantico, gli utenti aziendali possono porre domande in linguaggio naturale e ricevere risposte gestite e verificabili, basate su definizioni aziendali certificate. I team di data science possono creare applicazioni di intelligenza artificiale su una base già gestita, classificata e arricchita semanticamente, anziché impiegare mesi a preparare dati che avrebbero dovuto essere pronti fin dall'inizio. I dati conservati cessano di essere un costo infrastrutturale e diventano, per usare le parole del white paper di Solix Enterprise Data Preservation , "il carburante per analisi, scoperte e processi decisionali intelligenti".
Una diagnosi, non un'aspirazione.
Il modello di maturità è utile solo se applicato onestamente. Tre domande permettono di individuare la reale posizione di un'organizzazione in questo contesto.
I dati arrivano in un ambiente controllato fin dal primo byte, ovvero classificati, validati in termini di qualità e con vincoli di conservazione imposti al momento dell'acquisizione, oppure la governance viene applicata a posteriori, quando emerge un problema di conformità? Le organizzazioni che non sanno rispondere alla prima domanda corrono un rischio che aumenta con ogni applicazione di intelligenza artificiale implementata.
Esiste un livello semantico che codifica il significato aziendale delle applicazioni utilizzate dall'organizzazione, oppure i sistemi di intelligenza artificiale ragionano su schemi grezzi e deducono un contesto di cui non dispongono? Senza un livello semantico, gli output dell'IA non possono essere tracciati, spiegati o presentati con sicurezza.
Gli utenti aziendali possono interrogare i dati direttamente in linguaggio naturale, ottenendo risposte basate su definizioni certificate e riconducibili a una fonte specifica, oppure ogni domanda richiede ancora l'intervento di un team di esperti e l'apertura di una ticket di assistenza?
La distanza tra il "no" e il "sì" a ciascuna di queste domande è la distanza tra una soluzione ad hoc e una pronta per l'intelligenza artificiale. È una distanza percorribile, ma solo in sequenza e solo trattando ogni fase come una decisione deliberata piuttosto che come il risultato di eventi passati.

Stefano Tallant
Vicepresidente del marketing dei prodotti
ESCLUSIONE DI RESPONSABILITÀ: I CONTENUTI, LE OPINIONI E I PUNTI DI VISTA ESPRESSI IN QUESTO BLOG SONO ESCLUSIVAMENTE DELL'AUTORE/DEGLI AUTORI E NON RIFLETTONO LA POLITICA O LA POSIZIONE UFFICIALE DI SOLIX TECHNOLOGIES, INC., DELLE SUE AFFILIATE O DEI SUOI PARTNER. QUESTO BLOG È GESTITO IN MODO INDIPENDENTE E NON È REVISIONATO O APPROVATO DA SOLIX TECHNOLOGIES, INC. IN QUALIFICA UFFICIALE. TUTTI I MARCHI, I LOGHI E I MATERIALI PROTETTI DA COPYRIGHT DI TERZE PARTI QUI RIFERITI SONO DI PROPRIETÀ DEI RISPETTIVI TITOLARI. QUALSIASI UTILIZZO È RIGOROSAMENTE A SCOPO IDENTIFICATIVO, DI COMMENTO O DIDATTICO, AI SENSI DELLA DOTTRINA DEL FAIR USE (STATI UNITI COPYRIGHT ACT § 107 E EQUIVALENTI INTERNAZIONALI). NON È IMPLICITA ALCUNA SPONSORIZZAZIONE, APPROVAZIONE O AFFILIAZIONE CON SOLIX TECHNOLOGIES, INC. IL CONTENUTO VIENE FORNITO "COSÌ COM'È" SENZA GARANZIE DI ACCURATEZZA, COMPLETEZZA O IDONEITÀ PER QUALSIASI SCOPO. SOLIX TECHNOLOGIES, INC. DECLINA OGNI RESPONSABILITÀ PER AZIONI INTRAPRESE IN BASE A QUESTO MATERIALE. I LETTORI SI ASSUMONO LA PIENA RESPONSABILITÀ PER L'UTILIZZO DI QUESTE INFORMAZIONI. SOLIX RISPETTA I DIRITTI DI PROPRIETÀ INTELLETTUALE. PER PRESENTARE UNA RICHIESTA DI RIMOZIONE DMCA, INVIARE UN'E-MAIL A INFO@SOLIX.COM CON: (1) IDENTIFICAZIONE DELL'OPERA, (2) L'URL DEL MATERIALE CHE VIOLA, (3) I PROPRI DATI DI CONTATTO E (4) UNA DICHIARAZIONE DI BUONA FEDE. I RECLAMI VALIDI RICEVERANNO IMMEDIATA ATTENZIONE. ACCEDENDO A QUESTO BLOG, ACCETTI LA PRESENTE ESCLUSIONE DI RESPONSABILITÀ E I NOSTRI TERMINI DI UTILIZZO. IL PRESENTE CONTRATTO È REGOLATO DALLE LEGGI DELLA CALIFORNIA.
-
 White Paper
Architettura delle informazioni aziendali per Gen AI e Machine Learning
Scarica carta bianca -
-
-
 White Paper
Enterprise Intelligence: costruire le basi per il successo dell'intelligenza artificiale
Scarica carta bianca