臨床試験データのアーカイブ化 ― パート5/5
本シリーズの第1部では、コストセンターから戦略的資産への移行について解説しました。第2部では、過去のデータがAIトレーニングデータになるケースについて解説しました。第3部では、M&Aに伴うアーカイブの負担が統合的なメリットとなるケースについて解説しました。第4部では、アプリケーションのサイロ化が真の相互運用性へと移行するケースについて解説しました。今回の記事は、5つ目のテーマ、つまり最後のテーマです。難しい質問に答えるために、研究全体のデータを迅速に取得する必要が生じた場合、何が起こるのかを解説します。
今年初め、FDAは製薬会社に対し、GLP-1受容体作動薬であるサクセンダ、ウェゴビー、ゼプバウンドの3剤について、自殺念慮に関する警告表示を削除するよう要請した。この要請は、FDAが2023年7月に初めて関連性の可能性に関する報告を受けたことから始まった調査に基づくものだった。最終的な分析では、10万7910人の患者を対象とした91件のプラセボ対照試験と、220万人以上の患者を対象とした別の実世界研究を統合した。結論は、リスク増加は認められないというものだった。警告表示は削除された。
行間を読むと、本当の物語は発見そのものではなく、そこに至るまでの過程にある。91件の臨床試験の中には、2000年代半ばに遡るものもあり、異なるプロトコルに基づき、異なるチームによって実施されたもので、この特定の疑問が提起されるずっと以前のことだった。この疑問に答えるには、それぞれの研究から患者レベルのデータを抽出し、1つのデータセットに統合する必要があった。これは単なる検索ではなく、研究全体レベルでのデータ取得の問題であり、単一のフィールドやフォームの問題ではない。
ほとんどの臨床データ検索は、まだそのような用途には対応していません。アプリケーションレベルで構築されており、EDCにログインして1つの項目を確認し、eTMFにログインして別の項目を確認し、さらに安全性データベースにログインして別の項目を確認するといった具合です。それぞれの検索は単体では高速ですが、それらすべてを統合して完全で信頼できる研究記録を作成するのに、実際に時間がかかります。
その時間には大きなコストがかかり、それは決して小さなものではありません。生物医学研究全般において、広く引用されているある経済分析によると、米国における再現性のない前臨床研究の年間コストは約28億ドルに上り、その多くは記録されたデータから検証したり再構築したりすることができませんでした。臨床試験は前臨床研究よりも厳密に実施されますが、根本的な問題は同じです。つまり、どこかに技術的に保存されているデータと、実際に取得可能で、完全で、再分析できるデータは同じではないということです。
この種の「検索可能なデータ」には、分析結果データモデル(ARDM)という名称があります。ARDMは、生データにとどまらず、分析結果そのもの、つまり研究で生成される表、統計、図などを、構造化された機械可読な再利用可能なデータとして扱います。これは、誰もクエリを実行できない静的なPDFではありません。そのコンセプトは「一度書き込めば、何度でも使える」というものです。つまり、ある目的のために計算された結果は、文書に固定されて必要なたびに最初から再計算されるのではなく、次の目的のためにも検索可能な状態を維持するということです。
以下の4つの例は、想起のギャップを単なる1回の失敗として片付けることはできないことを示している。
2026年のある臨床試験。あるチームが、既に発表済みの臨床試験の結果を再現しようと試みた。この作業には5つのチームが協力し、数百人時を要した。元のデータ辞書は見つからず、結果を再現するために必要な統計的シード値も記録されていなかった。データが存在しなかったからではなく、試験プロトコルへのリンクが切れていたためだ。論文の結論は、プロトコル、辞書、方法を含む研究パッケージ全体がなければ、再利用はほとんど不可能だというものだ。
実世界での再現性、2019年。研究者らは、影響力の高い学術誌に掲載された米国の臨床試験220件を、実世界のデータ(電子カルテと保険請求データ)を用いて再現しようと試みたが、再現できたのはわずか33件(15%)に過ぎなかった。失敗のほとんどは、このシリーズで繰り返し指摘されている根本原因、すなわち、介入、適格基準、またはエンドポイントが、元の試験のシステム以外では構造化された検索可能な形式で記録されていなかったことに起因していた。
集中治療、2018年。集中治療試験における158の臨床実践に関する概観レビューでは、再現が試みられたのはわずか66件(42%)であった。そのうち56%は、元の研究と矛盾する結果をもたらした。当初は安全かつ効果的と判断された2つの実践は、適切な再検証の結果、後に有害であることが判明した。ヒドロキシエチルデンプンを用いた輸液蘇生は、有害であるという最も一貫した証拠があった。平均して、誰かが検証を試みるまでに4.6年かかった。
2016年のシステマティックレビューでは、検索自体が再現不可能な場合が多かった。25誌にわたる272件のシステマティックレビューをレビューしたところ、使用したすべてのデータベースで再現可能なほど詳細な検索戦略を報告していたのはわずか13%だった。検索語は91%のケースで報告されていたが、どのデータベースに適用されたか、また実際にいつ検索が実行されたかは、通常報告されていなかった。
問題は単にデータの検索だけではありません。報告される内容が、事前に規定された内容からずれてしまうこともあります。臨床試験登録に関する別の調査では、登録された主要評価項目と公表された主要評価項目との間に、中央値で31%の乖離が見られ、一部の研究では100%に達していました。また、副次評価項目についても、中央値で54%の乖離が見られました。結果が事後に変更された場合、統計的に有意な結果となるように変更されたケースが約半数ありました。
そのため、業界と規制当局の両方が、アプリケーションレベルではなく、研究レベルでのデータ取得へと移行しています。EMAは、2016年にポリシー0070が発効して以来、要約結果だけでなく、臨床試験報告書の完全な公開を積極的に義務付けています。ICMJEを通じて、ジャーナル編集者は2018年から治験のデータ共有計画を義務付けています。Vivliのような非営利プラットフォームは、研究者が複数のシステムから散在する文書ではなく、完全な研究データを要求できるようにするために存在します。「研究」が、互いに連携していないアプリケーションに断片的なデータとしてしか存在しない場合、これらの取り組みはどれも機能しません。
研究レベルの情報検索における5つの重要な要件:
- 研究全体を通して有効な単一の永続的なID文書やデータセットごとに1つのIDではなく、プロトコル、研究データ、分析コード、臨床試験報告書(CSR)を1つの検索可能な単位として結びつける1つのID。
- データセットだけでなく、完全なパッケージ2026年の単一試験の再解析は、その教訓となる事例である。プロトコル、辞書、解析方法のない生データは再利用できない。解析結果データモデル(ARDM)は、この点をさらに推し進めるものである。
- 5つの別々のログインではなく、1つの統制されたクエリ研究者や規制当局は、EDC、eTMF、統計リポジトリから再構築するのではなく、研究全体を一度に取得する必要がある。
- 種子の数まで含めた、記録された方法論この粒度での正確な再現性は、詳細に依存します。その時点で記録されなければ、後から復元することはできません。
- 古い研究も新しい研究も同じ方法で検索できますGLP-1のレビューでは、2000年代半ばの臨床試験と2020年代の試験を統合する必要がありました。前年の研究にしか対応しない検索システムは、そもそも検索システムとは言えません。それは一時的な便宜に過ぎません。
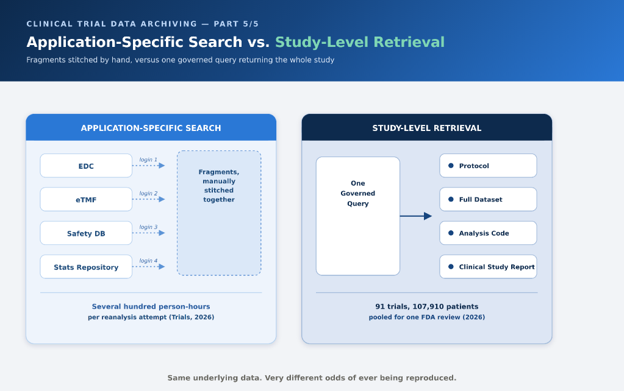
GLP-1の安全性レビューは、この話の良い面を描いたものです。「自殺リスクは本当にあるのか」という問いに答えるには、この疑問が生じるずっと以前に実施されたサクセンダの数十年にわたる臨床試験を、新しいウェゴビーやゼプバウンドの臨床試験と並べて、検索可能で統合可能なデータとして扱う必要がありました。これは、試験の全記録が、作成元のシステムにたまたま残っていたファイルのフォルダではなく、一貫性のある検索可能なパッケージとして残っている場合にのみ有効です。幸いにも、当局は91件の試験を統合し、推測ではなく実際のデータに基づいて、注目度の高い安全性の疑問を解決することができました。その結果、警告表示が悪化するのではなく、削除されたのです。
このリストにあるものはすべて、このシリーズの第3部で紹介したFAIR原則を、個々の記録ではなく研究レベルで適用したものです。
- 見つけやすいすべての研究には、別々のシステムに分散した文書IDではなく、永続的な単一のIDが付与されます。
- アクセス可能な統制された検索プロセスにより、システム間を手作業で検索するのではなく、要求に応じて研究全体が返されます。
- 相互運用性古い研究と新しい研究は、翻訳プロジェクトを必要とせずに同じ統合分析に含めることができる構造を採用している。
- 再利用可能なプロトコル、データ辞書、分析方法、および結果はまとめて管理されるため、再分析を行う際に、誰も書き留めていない詳細を記憶しておく必要はありません。
これらのいずれかをスキップすると、研究レベルの検索は、技術的には可能だが実際には遅く、リンク切れが1つで再現不可能な結果につながる可能性のある、アプリケーション固有の検索に静かに切り替わります。
これでブログシリーズは終了となるので、全体の流れを明確にしておきましょう。各ブログは、コストの正当性、AIの関連性、M&Aのメリット、アプリケーションの乱立、検索結果など、それぞれ異なる問題を取り上げていました。しかし、どれも本質的には同じ疑問を異なる角度から問いかけているのです。つまり、データが作成された場にいなかった人が、データを見つけ、信頼し、再利用できるほど、データは適切に管理されているか、ということです。
- ディメンション1 - コストセンターから戦略的資産へ過去の臨床試験データを適切に再利用することで、開発期間を短縮できる。
- ディメンション2 - バックミラーからトレーニングデータへその同じアーカイブは、AIモデルの原材料となり得る。ただし、その出所がモデル自体と同様に厳密に文書化されていることが条件となる。
- ディメンション3 - アーカイブの負担から統合された利点へM&Aはアーカイブを増大させるが、FAIR原則こそが、2社のデータを2つのファイルキャビネットではなく、1つの利用可能なリソースに変えることを可能にする。
- ディメンション4 - アプリケーションのサイロ化から真の相互運用性へ最高水準のアプリケーションは、真の相互運用性と共存できるが、そのためには、それらすべての下に共通の統制されたデータ層が存在する必要がある。
- 次元5 — アプリケーション固有の検索から研究レベルの情報検索まで上記すべては、必要に応じて研究全体を完全な形で再現可能な状態で取り出すことができる場合にのみ報われる。
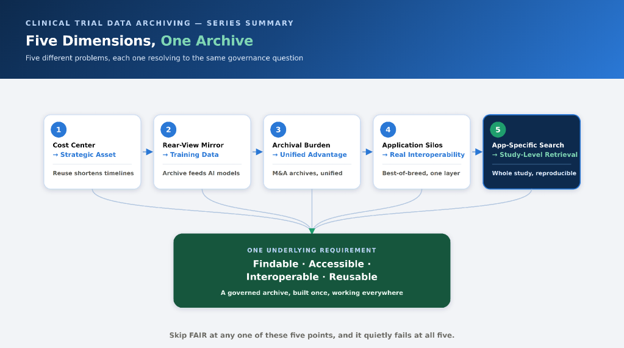
5つの別々の問題があり、その根底にある要件は1つです。それは、AI、M&A、データを生成するアプリケーション、そして現時点では誰かが研究全体を再現する必要があるため、検索可能で、アクセス可能で、相互運用可能で、再利用可能なデータであることです。
これら5つの要素はどれも単独では機能せず、また単独では何も機能しません。作成と再利用が安価であっても、AIモデルへのデータ供給ができず、買収後に統合できず、マルチベンダーのアプリケーションスタックに対応できず、規制圧力の下でも完全に取得できないアーカイブは、実際には完成形とは言えません。FAIR原則は、これら5つの問題のいずれか一つだけを解決しようとするものではなく、常にこれらすべてを同時に解決しようとするものでした。
もし貴社がパイプラインのより早い段階でAIを適用している問題がこれと同じであれば、同僚のRohit PardeshiとSoumith Babburiによるホワイトペーパーは一見の価値があります。このホワイトペーパーでは、接続されたデータインフラストラクチャを使用してAI駆動の薬剤再利用と標的特定を加速するためのフレームワークが示されています。これは、このブログで主張している「分野だけでなく研究全体」という論理を、既に研究された内容をどのように擁護するかではなく、次に何を研究するかを決定することに適用したものです。製薬R&DにおけるAI駆動の薬剤再利用と標的特定のためのフレームワーク。
生物統計学、規制関連業務、またはデータ管理の分野で働いている場合、規制当局が明日、ある製品に関する過去15年間のすべての臨床試験を統合するよう組織に要求した場合、研究全体を収集しますか、それとも申請書ごとに再構築しますか?
よくあるご質問
臨床試験データ管理における研究レベルのデータ検索とは何ですか?
研究レベルの検索とは、個別のアプリケーションで個々の記録を検索するのではなく、管理された信頼できるパッケージとして、臨床試験全体を検索することを意味します。プロトコル、研究データ、分析方法、臨床試験報告書を連携させることで、研究全体を検索し、再利用することが可能になります。
アプリケーション固有の検索と研究レベルの検索の違いは何ですか?
アプリケーション固有の検索では、EDC、eTMF、安全性データベースなど、システムごとに情報を取得します。治験レベルの検索では、管理された単一のリクエストで治験全体の情報を取得できるため、複数の連携していないシステムから手動で情報を再構築する必要性が軽減されます。
臨床試験データにおいて、研究レベルのデータ検索が重要なのはなぜですか?
研究レベルでのデータ検索機能により、臨床試験データの検索、アクセス、分析、再現、再利用が容易になります。データのみを保持するだけでは不十分であり、関連するプロトコル、データ辞書、方法論、および結果も検索可能で相互に関連付けられている必要があります。
臨床試験データパッケージには何を含めるべきでしょうか?
臨床試験の完全なパッケージには、試験プロトコル、試験データ、データ辞書、解析コードまたは解析方法、および臨床試験報告書が含まれるべきです。これらの構成要素は、生データだけに頼るのではなく、試験を理解し、再現し、再利用するために必要なコンテキストを提供します。
分析結果データモデル(ARDM)とは何ですか?
分析結果データモデル(ARDM)は、表、統計情報、図などの分析出力を、静的な文書ではなく、構造化された機械可読な再利用可能なデータとして扱います。このアプローチにより、分析結果を最初から再計算することなく、将来の使用のために取得できるようになります。
研究レベルのデータ検索は、臨床試験の再現性をどのようにサポートするのか?
研究レベルの検索機能は、研究を再現するために必要な情報をまとめて保持することで、再現性を支援します。これには、プロトコル、データ辞書、分析方法、その他の方法論の詳細、必要に応じて統計シード数などの正確な情報が含まれます。
研究レベルの情報検索における5つの重要な要件は何ですか?
重要な要件は5つあり、研究全体を通して使用できる単一の永続的なID、完全な研究パッケージ、複数のアプリケーション検索ではなく、管理された単一のクエリ、記録された方法論、そして過去の研究と新しい研究の両方を一貫して検索できることである。
FAIR原則は、臨床試験データの取得にどのように適用されるのでしょうか?
FAIR原則は、臨床試験データを検索可能(Findable)、アクセス可能(Accessible)、相互運用可能(Interoperable)、再利用可能(Reusable)にするものです。研究レベルでは、これは永続的な研究識別子の使用、管理された検索、互換性のある構造、そしてプロトコル、データ、方法、結果をまとめて保管することを意味します。
研究レベルの情報検索は、規制当局による審査や安全性分析をどのように支援するのでしょうか?
研究レベルのデータ検索により、研究者や規制当局は、重要な安全性や規制上の疑問を調査する際に、臨床試験の全データにアクセスして集約することができます。GLP-1の安全性レビューは、過去の試験データを検索し、新しい研究データと組み合わせて特定の安全性に関する疑問に答える方法を示しています。
なぜ古い臨床試験も新しい臨床試験と同じ方法で検索できるようにする必要があるのでしょうか?
規制審査、安全性分析、または研究においては、過去の研究と最新の研究を組み合わせる必要がある場合がある。したがって、検索システムは、最近作成されたデータのみを検索対象とするのではなく、同じ統制されたアプローチを通じて、古い研究と新しい研究の両方にアクセスできるようにすべきである。
参考情報
- 米国FDA、「FDA、GLP-1受容体作動薬からの自殺行動および自殺念慮に関する警告の削除を要請」(2026年4月) fda.gov/drugs/drug-safety-communications/fda-requests-removal-suicidal-behavior-and-ideation-warning-glucagon-peptide-1-receptor-agonist-glp
- Science News、「米国における再現性のない生命科学研究のコストは28億ドル」は、Freedman、Cockburn、Simcoeによる「前臨床研究における再現性の経済学」PLOS Biology(2015)を報じている。 sciencenews.org/article/irreproducible-life-sciences-research-us-costs-28-billion
- キルヒナー他、「臨床研究データの再考:分析結果をデータとして尊重すべき理由」、Scientific Data(2022)— Nature.com/articles/s41597-022-01789-2
- Ansari et al.、「影響力の高い小児科、心臓病学、外科のジャーナルに掲載されたシステマティックレビューにおける検索戦略の再現性は低い」、PLOS One(2016)— Journal.plos.org/plosone/article?id=10.1371/journal.pone.0163309
- Trials(Springer Nature)、「臨床試験データの再解析と再利用の支援:事例研究」(2026)— link.springer.com/article/10.1186/s13063-026-09646-y
- Niven et al.、「集中治療における臨床研究の再現性:概観レビュー」、BMC Medicine(2018)— link.springer.com/article/10.1186/s12916-018-1018-6
- Franklin et al.、「臨床試験のエビデンスを再現するための実世界データの使用可能性」、JAMA Network Open (2020) — jamanetwork.com/journals/jamanetworkopen/fullarticle/2752575
- Jones et al.、「ランダム化比較試験における登録結果と公表結果の比較:系統的レビュー」、BMC Medicine(2015)— link.springer.com/article/10.1186/s12916-015-0520-3
- ニューイングランド・ジャーナル・オブ・メディシン、「透明性と欧州医薬品庁 ― 臨床試験データの共有」(2015年)― nejm.org/doi/full/10.1056/NEJMp1409464
- Wilkinson et al.、「科学データ管理とスチュワードシップのためのFAIR原則」、Scientific Data(2016)— nature.com/articles/sdata201618
- Vivliは、非営利のグローバル臨床研究データ共有プラットフォームです。 vivli.org
#臨床試験 #臨床データ管理 #ライフサイエンス #再現性 #FAIRデータ #データ戦略 #医薬品開発 #薬事規制

ムラリ・クリシュナム
VP - 製品戦略、エンタープライズ製薬AI
免責事項:このブログに掲載されている内容、見解、意見は、すべて著者の見解であり、SOLIX TECHNOLOGIES, INC.、その関連会社、またはパートナーの公式な方針または立場を反映するものではありません。このブログは独立して運営されており、SOLIX TECHNOLOGIES, INC.による公式な立場での審査または承認は受けていません。本ブログに記載されているすべての第三者の商標、ロゴ、著作権で保護された資料は、それぞれの所有者の財産です。いかなる使用も、フェアユースの原則(米国著作権法第107条および国際的に同等の条項)に基づき、識別、解説、または教育目的に限定されます。SOLIX TECHNOLOGIES, INC.とのスポンサーシップ、推奨、または提携関係を示唆するものではありません。コンテンツは「現状のまま」提供され、正確性、完全性、またはいかなる目的への適合性についても保証されません。SOLIX TECHNOLOGIES, INC.は、本資料に基づいて行われた行動について一切の責任を負いません。読者は、本情報の使用について全責任を負うものとします。SOLIXは知的財産権を尊重します。 DMCA削除要請を提出するには、以下の情報を添えてINFO@SOLIX.COMまでメールでお送りください:(1) 作品の識別情報、(2) 著作権を侵害しているコンテンツのURL、(3) お客様の連絡先、(4) 誠意の表明。正当な申し立てには速やかに対応いたします。このブログにアクセスすることにより、お客様は本免責事項および当社の利用規約に同意したものとみなされます。本契約はカリフォルニア州法に準拠します。