ほとんどのAIプログラムが交わしていない会話
AIパイロットプロジェクトからAIプログラムへと移行する組織には、共通するパターンが一つあります。それは、規模拡大によって問題が顕在化する前に、アーキテクチャに関する課題を解決していたことです。つまり、2番目または3番目の本番アプリケーションが展開される前に、ストレージ特性、セマンティックレイヤー、パイプライン制御といった観点から、データ基盤がどのようなものであるべきかを明確に定義していたのです。
ほとんどの企業はこの手順を踏んでいません。モデルが選択され、ユースケースが定義され、概念実証が構築されます。そして、データ基盤は、プログラムの成長に伴って対処されるものとして扱われます。エンタープライズ環境では、この前提が、最終的に規模拡大を試みる際に、遅延とコストの原因となることが常態化しています。
アクセシビリティはAI対応と同じではない
AIプログラムの初期計画段階で見落とされがちなのは、アクセス可能なデータとAI対応データの違いである。
アクセス可能なデータはクエリを実行できます。システム内に存在し、抽出可能で、モデルを適用できます。ほとんどの企業データはこの条件を満たしています。AI対応データは、取り込み時点から管理され、検証済みの意味を持ち、モデルに到達する前に品質検証済みであり、ソースから回答まで途切れなく追跡可能です。
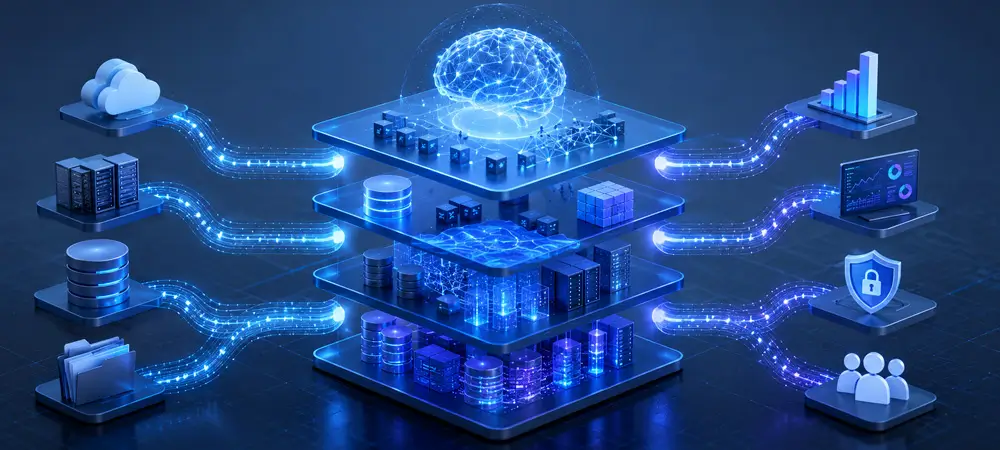
これら2つの定義のギャップは、データ品質プロジェクトではなく、アーキテクチャ上の問題です。エンタープライズAIが要求する規模で、データを遡及的に管理することはできません。エンタープライズAIの拡張性を左右する3つのレイヤー(ストレージ、メタデータ、パイプライン)はそれぞれ異なる役割を担い、次のレイヤーが依存する条件を作り出します。
なぜ基礎工事は常に最後に行われるのか
ほとんどの企業データ環境は、AIを念頭に置いて設計されていません。データはトランザクション処理用に構築されたストレージシステムに格納されます。メタデータは、存在する場合でも、スプレッドシートに記録されていたり、データ辞書に埋もれていたり、あるいは元のシステムを構築したエンジニアの頭の中にしか存在していません。パイプラインは単発的に構築されたものであり、大規模な本番環境のAIアプリケーションにデータを供給するようには設計されていません。
その結果、あらゆるAIイニシアチブは事実上、データレイヤーをゼロから構築することになります。品質チェックは一貫性を欠き、ガバナンスは後付けで追加されます。汎用的な機械学習プラットフォームはモデル開発のためのツールを提供しますが、ガバナンスの効いたデータ取り込み、セマンティックレイヤー、あるいは実際の企業データでこれらのツールを信頼できるものにするための本番環境レベルの品質管理は提供しません。顧客はこれらのレイヤーを自ら構築するため、AIイニシアチブは当初のビジネスケースで想定されていたよりも時間がかかり、コストも高額になるのです。
3つの階層、3つの異なる仕事
ストレージ層は、ガバナンスが開始されるか、あるいは恒久的に延期される場所です。ACIDトランザクション、スキーマ進化、タイムトラベルクエリはパフォーマンス機能ではなく、ガバナンス要件です。スキーマ進化が重要なのは、エンタープライズソースシステムが継続的に変化するためです。これらの変化を吸収できないストレージ層は、その上のすべてのAIイニシアチブのボトルネックになります。タイムトラベルクエリを使用すると、規制対象企業は手動でデータを再構築することなく、過去の監査に関する質問に答えることができます。取り込み時に保持を強制することで、ほとんどの組織が現在アーキテクチャではなくプロセスとドキュメントで管理しているコンプライアンスリスクのクラス全体を排除できます。Solixは、Apache Hudiベースのガバナンスされたレイクハウスと、エンタープライズアプリケーションデータ専用の保存ゾーンを通じてこれを実現し、データが到着した瞬間から保持と法的保留機能が有効になります。
メタデータ層は、データが意味を持つようになる場所であり、ほとんどのエンタープライズAI基盤が最も脆弱な部分でもあります。データベーススキーマは、フィールドが存在することを示すだけで、それらが何を表しているのか、アプリケーション間でどのように関連しているのかは示しません。生のスキーマに基づいて推論を行うAIシステムは、本来持っていないビジネス上の意味を推論し、説明もソースの追跡もできない出力を生成します。アプリケーションナレッジグラフはこのギャップを埋めます。これは、エンタープライズアプリケーションに固有のビジネスオブジェクト、関係、語彙、およびテスト済みのクエリパターンをエンコードするセマンティック層です。Solixは、Oracle EBS、SAP ECC/S4HANA、PeopleSoft、およびJD Edwards向けに事前構築済みのアプリケーションナレッジグラフを提供しており、セマンティック構築の中で最も時間のかかる層を顧客から取り除きます。非構造化コンテンツの場合、取り込み時に構築されるセマンティックインデックスが同じ原則を適用します。つまり、モデルが推論を行う前に意味がエンコードされます。その結果、認定されたビジネス定義に遡って追跡でき、規制当局や取締役会に自信を持って提示できるAIの回答が得られます。
パイプライン層は、下流のAI出力の信頼性が決定される場所です。自動プロファイリング、品質ルール、データ系統追跡、データ準備ワークフローにより、欠陥のあるAI推奨がビジネス上の意思決定に影響を与えた後ではなく、データ取り込み段階で問題が検出されます。Solixはこのプロセスを、データ取り込み、ガバナンスされたレイクハウス、データ品質、機械学習フローという4つの連続したガバナンスされたステージとして構成しており、それぞれ監査可能で、データが到着してからAIで本番環境で使用される準備が整うまでの時間を短縮します。
実用段階の基盤とはどのようなものか
金融サービス企業が、Oracle EBSとSAPのデータに加え、リアルタイムの運用フィードや廃止されたアプリケーションのアーカイブ済みレコードを統合するケースを考えてみましょう。目標は、ビジネスユーザーが自然言語でアクセスできるAI搭載のリスクおよび運用インテリジェンスプラットフォームと、データサイエンスチームのための統制された基盤を構築することです。
ストレージ層では、データはACIDトランザクション、スキーマ進化、規制上の参照のためのタイムトラベルクエリを備えた、管理されたデータセンターに格納されます。レガシーアプリケーションのデータは、管理された保存ゾーンに移動され、到着時から保持管理され、法的保留に対応できる状態になっています。
メタデータ層では、Oracle EBSおよびSAP用の事前構築済みアプリケーションナレッジグラフが組織固有の設定に合わせて構成され、調達から支払い、受注から入金、記録から報告までのバリューストリームがエンコードされます。統合資産カタログは、システム全体にわたって認証済みのビジネス定義とデータリネージを維持します。ビジネスアナリストが自然言語でクエリを実行したり、リスクモデルがデータを照会したりすると、回答は生のテーブルからの推論ではなく、認証済みの定義に遡って表示されます。
パイプライン層では、データがモデルに到達する前に品質ルールが適用されます。データリネージは、ソースからAI対応製品に至るまでのすべての要素を追跡します。データサイエンスチームは、統制されたデータに基づいて作業を進めることができ、最初のモデルをトレーニングする前に何ヶ月もかけて個別のデータエンジニアリングを行う必要はありません。
次期AIイニシアチブの規模拡大前に問うべき3つの質問
AI投資の次の段階に進む前に、データアーキテクチャに関して、チームに直接尋ねるべき3つの質問があります。
データは最初のバイトから、品質検証、保持ポリシー、監査証跡が取り込まれる時点で適用される統制された環境に置かれるのか、それとも問題が発生した後に事後的に統制が適用されるのか。最初の質問に答えられない組織は、その上に展開されるAIアプリケーションが増えるごとに、コンプライアンスリスクが増大する。
そのデータに基づいて動作するAIシステムは、ビジネス上の意味を符号化するセマンティックレイヤーを備えているのか、それとも生のスキーマに対して直接推論を行っているのか?セマンティックレイヤーがなければ、AIの出力は確実に追跡、説明、または擁護することができない。
AIモデルにデータを供給するパイプラインは、統制され、データ系列が追跡可能なデータ製品を生成するのか、それとも各新規プロジェクトが独自に再設計しなければならない生データ入力を生成するのか?後者の場合、データエンジニアリングのコストを基盤として一度支払うのではなく、プロジェクトごとに繰り返し支払うことになる。
これらの質問のいずれかが、本来あるべきよりも回答が難しい場合、そこからアーキテクチャレビューが始まり、拡張可能なエンタープライズAIの設計図が作成されます。

スティーブン・タラント
製品マーケティング担当副社長
免責事項:このブログに掲載されている内容、見解、意見は、すべて著者の見解であり、SOLIX TECHNOLOGIES, INC.、その関連会社、またはパートナーの公式な方針または立場を反映するものではありません。このブログは独立して運営されており、SOLIX TECHNOLOGIES, INC.による公式な立場での審査または承認は受けていません。本ブログに記載されているすべての第三者の商標、ロゴ、著作権で保護された資料は、それぞれの所有者の財産です。いかなる使用も、フェアユースの原則(米国著作権法第107条および国際的に同等の条項)に基づき、識別、解説、または教育目的に限定されます。SOLIX TECHNOLOGIES, INC.とのスポンサーシップ、推奨、または提携関係を示唆するものではありません。コンテンツは「現状のまま」提供され、正確性、完全性、またはいかなる目的への適合性についても保証されません。SOLIX TECHNOLOGIES, INC.は、本資料に基づいて行われた行動について一切の責任を負いません。読者は、本情報の使用について全責任を負うものとします。SOLIXは知的財産権を尊重します。 DMCA削除要請を提出するには、以下の情報を添えてINFO@SOLIX.COMまでメールでお送りください:(1) 作品の識別情報、(2) 著作権を侵害しているコンテンツのURL、(3) お客様の連絡先、(4) 誠意の表明。正当な申し立てには速やかに対応いたします。このブログにアクセスすることにより、お客様は本免責事項および当社の利用規約に同意したものとみなされます。本契約はカリフォルニア州法に準拠します。