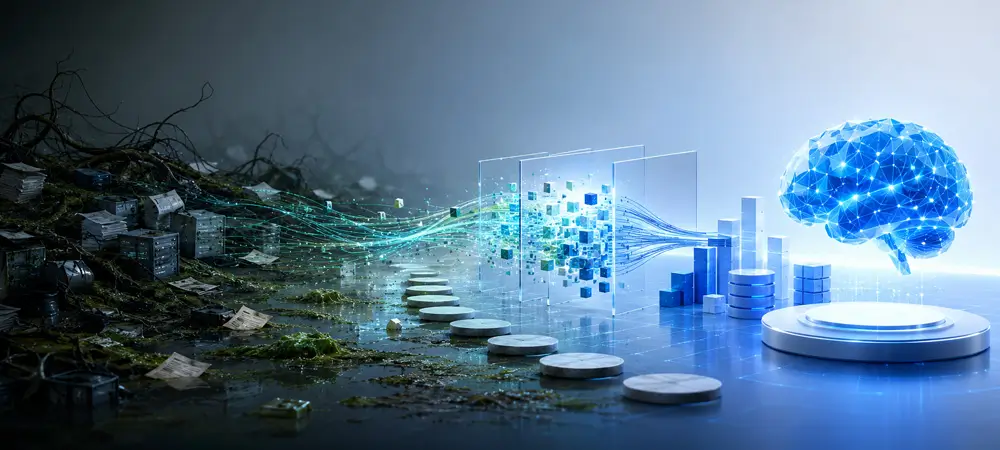
ほとんどの企業データは複雑ではない。ただ、管理されていないだけだ。
組織は自社のデータ環境を複雑だと表現しますが、実際にはもっと正確な意味合いがあります。つまり、共有するように設計されていないシステム間でデータが蓄積され、廃止されたアプリケーションには現在のチームが見たこともない形式で数十年分のビジネス履歴が保存され、メタデータはスプレッドシートか、もはや利用できないかもしれないエンジニアの記憶の中にしか存在せず、すべてのAIイニシアチブは同じように始まります。最初のモデルをトレーニングする前に、何ヶ月ものデータエンジニアリング作業が必要になるのです。
それは複雑さではなく、ガバナンスの欠如です。そして、この区別は重要です。なぜなら、複雑さとは問題がアーキテクチャ上の問題、つまり新しいプラットフォーム、新しい投資、新しいインフラストラクチャを必要とする問題を意味するからです。ガバナンスのないデータは構造的な問題であり、データが到着した瞬間から始まる一連の明確な意思決定によって解決できる問題なのです。
3つの段階、1つのシーケンス
データスワンプからAI対応アセットへの道のりは、アドホック、管理、最適化の3つの段階を経て進みます。多くの企業は、実際よりも進んでいると思い込んでいます。診断は簡単です。AIイニシアチブで最初のモデルをトレーニングするまでに数ヶ月のデータエンジニアリングが必要な場合、データはアドホックです。AIの出力がソースに追跡できない場合、セマンティックレイヤーが欠落しています。「このデータを照会できるのは誰か?」という質問に対する答えが「チケットを発行した後のデータチーム」である場合、最適化段階には達していません。
この3つの段階は連続したものではなく、順序立てたものです。最適化には管理された状態が前提条件となります。最適化された状態に最も早く到達できる組織は、各段階を偶然に蓄積された結果ではなく、設計上の決定として捉えた組織です。
ステージ1:アドホック — エンタープライズデータの大部分が存在する場所
アドホック段階では、データは存在するものの、信頼性をもって利用することはできません。そのため、トランザクション処理用に構築されたストレージシステムに格納されます。廃止されたアプリケーションには、財務記録、調達データ、顧客取引など、数年あるいは数十年にわたるビジネス履歴が保存されていますが、そのデータにコンテキストを提供していたアプリケーション自体は既に廃止されています。残されたものは、多くの場合、不可解なものです。元の開発者にとって意味のあるテーブル名、別の年代に書かれたソフトウェアから引き継がれた列の命名規則、データベーススキーマではなくアプリケーションロジックにエンコードされた関係性などです。
AIイニシアチブの開始時に、そのコストが発生します。データエンジニアリングチームは、新しいプロジェクトごとに専用のデータ取り込みパイプラインを構築します。品質チェックは一貫性がなく、あるいは全く行われません。ガバナンス(保持ポリシー、アクセス制御、分類など)はどこかに文書化されていますが、データが実際に存在するシステムでは適用されていません。各プロジェクトは同じ基盤を再構築することになります。AI投資のビジネスケースは、最初のモデルがトレーニングされる前に損なわれます。なぜなら、そのモデルに必要なデータが準備できていないからです。
ステージ2:管理型 — インテリジェンスよりもガバナンスを優先
管理段階はデータの取り込みから始まります。データは、最初のバイトから保持ポリシーが適用され、データが下流システムに到達する前に品質チェックが実行され、組織独自の分類体系に基づいてレコードが分類タグ付けされ、データが到着した瞬間から法的保持機能が有効になる、統制された環境に到着します。これはストレージのアップグレードではありません。データの受信方法の構造的な変更であり、単一のポリシーモデルの下で、廃止されたアプリケーション、買収したシステム、および稼働中の本番環境からのデータを統制された一元的な場所として提供する、保存ゾーンアーキテクチャです。
執行レイヤーはガバナンスプラットフォームに組み込まれています。保持はリアルタイムで適用され、マスキングはアクセス時に強制され、すべてのガバナンスアクションは変更不可能な監査証跡に記録されます。管理段階ではAIの出力は生成されません。分類、検証、ガバナンス、法的防御が可能な、十分に信頼できるデータが生成されます。この段階に到達した組織は、コンプライアンスの問題を解決しています。しかし、まだ解決できていないのは、意味の問題です。
ステージ3:最適化 — データが燃料となる時
マネージドデータは、セマンティックレイヤーが追加されることでAI対応になります。これは、ほとんどの汎用プラットフォームが省略している移行であり、AIが検証済みのビジネス意味に基づいて動作するか、推論されたスキーマに基づいて動作するかを決定づけるものです。データベーススキーマは、存在するフィールドを識別するだけで、それらが何を表しているのか、ビジネスが実行するバリューストリーム全体でどのように関連しているのか、あるいはそのアプリケーションのコンテキストで有効なクエリパターンが何であるかをエンコードするものではありません。生のスキーマに基づいて推論するAIシステムは推測に過ぎません。その結果として得られる回答は、説明も追跡もできず、ビジネス上の意思決定において信頼することもできません。
アプリケーションナレッジグラフは、そのギャップを埋めます。企業アプリケーションに固有のビジネスオブジェクト、関係、語彙、およびテスト済みのクエリパターンをエンコードします。Solixは、Oracle EBS、SAP ECC/S4HANA、PeopleSoft、およびJD Edwards (企業構造化データの大部分を保持するERPシステム)向けに、事前に構築されたアプリケーションナレッジグラフを提供しています。また、事前に構築された同等のものが存在しないレガシーアプリケーションや買収したアプリケーション向けには、AIを活用した検出を通じてカスタムナレッジグラフを構築します。非構造化コンテンツについては、コンテンツインテリジェンスがドキュメント、契約書、レコードにセマンティックレイヤーを構築し、単一の統制されたインターフェースで構造化データと並んでクエリできるようにします。
セマンティックレイヤーが導入されたことで、ビジネスユーザーは自然言語で質問し、認証済みのビジネス定義に基づいた、統制され監査可能な回答を受け取ることができます。データサイエンスチームは、既に統制され、分類され、セマンティックに強化された基盤の上にAIアプリケーションを構築できるため、本来到着時に準備されているべきデータを何ヶ月もかけて準備する必要がなくなります。保存されたデータはインフラストラクチャコストではなくなり、Solix Enterprise Data Preservationのホワイトペーパーにあるように、「インテリジェントな分析、発見、意思決定のための燃料」となります。
診断であって、吸引ではない
成熟度モデルは、正直に適用した場合にのみ有効です。組織が実際にどの段階にあるかは、以下の3つの質問で明らかになります。
データは、最初のバイトから管理された環境(取り込み時に分類、品質検証、保持期間の適用が行われている環境)に到着するのか、それともコンプライアンス上の問題が浮上した後に事後的にガバナンスが適用されるのか。最初の質問に答えられない組織は、その上に展開されるAIアプリケーションが増えるごとにリスクが増大することになる。
組織が運用するアプリケーションには、ビジネス上の意味を符号化するセマンティックレイヤーが存在するのか、それともAIシステムは生のスキーマに基づいて推論し、自身には存在しないコンテキストを推測しているのか。セマンティックレイヤーがなければ、AIの出力は確実に追跡、説明、あるいは自信を持って提示することはできない。
ビジネスユーザーは、認証された定義に基づき、情報源まで追跡可能な回答を自然言語で直接取得できるのでしょうか?それとも、すべての質問に対してデータチームとチケットキューが必要なのでしょうか?
これらの質問に対する「いいえ」と「はい」の間の距離は、場当たり的な対応とAI対応の間の距離に相当します。それは乗り越えられる距離ですが、それは順序立てて、各段階を過去の出来事の結果としてではなく、意図的な決定として扱うことによってのみ可能です。

スティーブン・タラント
製品マーケティング担当副社長
免責事項:このブログに掲載されている内容、見解、意見は、すべて著者の見解であり、SOLIX TECHNOLOGIES, INC.、その関連会社、またはパートナーの公式な方針または立場を反映するものではありません。このブログは独立して運営されており、SOLIX TECHNOLOGIES, INC.による公式な立場での審査または承認は受けていません。本ブログに記載されているすべての第三者の商標、ロゴ、著作権で保護された資料は、それぞれの所有者の財産です。いかなる使用も、フェアユースの原則(米国著作権法第107条および国際的に同等の条項)に基づき、識別、解説、または教育目的に限定されます。SOLIX TECHNOLOGIES, INC.とのスポンサーシップ、推奨、または提携関係を示唆するものではありません。コンテンツは「現状のまま」提供され、正確性、完全性、またはいかなる目的への適合性についても保証されません。SOLIX TECHNOLOGIES, INC.は、本資料に基づいて行われた行動について一切の責任を負いません。読者は、本情報の使用について全責任を負うものとします。SOLIXは知的財産権を尊重します。 DMCA削除要請を提出するには、以下の情報を添えてINFO@SOLIX.COMまでメールでお送りください:(1) 作品の識別情報、(2) 著作権を侵害しているコンテンツのURL、(3) お客様の連絡先、(4) 誠意の表明。正当な申し立てには速やかに対応いたします。このブログにアクセスすることにより、お客様は本免責事項および当社の利用規約に同意したものとみなされます。本契約はカリフォルニア州法に準拠します。