ARQUIVAMENTO DE DADOS DE ENSAIOS CLÍNICOS — PARTE 5/5
A Parte 1 desta série abordou a transformação de centros de custo em ativos estratégicos. A Parte 2 tratou da transformação de dados retrospectivos em dados de treinamento de IA. A Parte 3 explorou a transformação da sobrecarga de arquivamento resultante de fusões e aquisições em uma vantagem unificada. A Parte 4 abordou a transformação de silos de aplicativos em interoperabilidade real. Este post é a quinta e última dimensão: o que acontece quando alguém precisa recuperar rapidamente os dados de um estudo completo para responder a uma pergunta complexa.
No início deste ano, a FDA solicitou aos fabricantes de medicamentos que removessem o alerta sobre pensamentos suicidas de três medicamentos para perda de peso à base de GLP-1: Saxenda, Wegovy e Zepbound. Essa solicitação ocorreu após uma revisão iniciada em julho de 2023, quando a agência recebeu os primeiros relatos de uma possível ligação. A análise final reuniu 91 ensaios clínicos controlados por placebo, abrangendo 107,910 pacientes, além de um estudo separado no mundo real com mais de 2.2 milhões de pacientes. A conclusão: nenhum aumento de risco. O alerta foi removido.
Lendo nas entrelinhas, a verdadeira história não é a descoberta em si, mas sim o processo para chegar até ela. Alguns desses 91 ensaios clínicos remontam a meados dos anos 2000, conduzidos sob protocolos diferentes, por equipes distintas, muito antes de alguém se fazer essa pergunta específica. Respondê-la significou extrair dados individuais de cada paciente de cada um desses estudos e reuni-los em um único conjunto de dados. Isso não é uma simples busca, mas sim um problema de recuperação de dados, no nível do estudo como um todo, e não em um campo ou formulário específico.
A maioria das buscas de dados clínicos ainda não foi projetada para isso. Elas são construídas no nível do aplicativo: faça login no EDC para verificar uma coisa, no eTMF para outra e em um banco de dados de segurança para uma terceira. Cada busca é rápida individualmente, mas é na integração de todas as informações em um registro de estudo completo e confiável que o tempo é realmente gasto.
Esse tempo tem um custo real, e não é pequeno. Em toda a pesquisa biomédica, uma análise econômica amplamente citada estimou o custo anual da pesquisa pré-clínica irreproduzível nos EUA em cerca de US$ 28 bilhões, grande parte dos quais não pôde ser verificada ou reconstruída a partir do que foi registrado. Os ensaios clínicos são conduzidos com mais rigor do que o trabalho pré-clínico, mas o mesmo problema subjacente persiste: dados que são tecnicamente armazenados em algum lugar não são os mesmos que dados que são de fato recuperáveis, completos e prontos para serem reanalisados.
Existe um nome para esse tipo de dado "recuperável": o Modelo de Dados de Resultados de Análise (ARDM, na sigla em inglês) . Em vez de se limitar aos dados brutos, ele trata o próprio resultado da análise — as tabelas, estatísticas e figuras produzidas por um estudo — como dados estruturados, legíveis por máquina e reutilizáveis, e não como um PDF estático que ninguém consegue consultar. A ideia é " escrever uma vez, usar indefinidamente ": um resultado calculado para um propósito permanece recuperável para o próximo, em vez de ficar preso em um documento e ser recalculado do zero sempre que alguém precisar dele.
Os quatro exemplos abaixo tornam impossível descartar a lacuna de recuperação como um único teste malsucedido.
Um ensaio clínico, em 2026 , reproduziu os resultados de um estudo clínico já publicado. O esforço consumiu centenas de horas de trabalho de cinco equipes distintas: o dicionário de dados original não foi encontrado e os números de referência estatísticos necessários para reproduzir os resultados nunca foram registrados. Não porque os dados não existissem, mas porque o link para o protocolo do ensaio estava quebrado. A conclusão do artigo: sem o pacote completo do estudo, que inclui protocolo, dicionário e métodos, a reutilização dificilmente funciona.
Replicação no mundo real , 2019. Pesquisadores tentaram replicar 220 ensaios clínicos americanos publicados em periódicos de alto impacto usando dados do mundo real (prontuários eletrônicos de saúde e registros de planos de saúde), com apenas 33 ensaios (15%) sendo replicados. A maioria das falhas foi atribuída à mesma causa raiz que esta série vem destacando: a intervenção, os critérios de elegibilidade ou o desfecho não foram registrados de forma estruturada e recuperável fora dos sistemas do ensaio original.
Em 2018 , uma revisão exploratória de 158 práticas clínicas provenientes de ensaios clínicos em terapia intensiva revelou que apenas 66 delas (42%) foram reproduzidas. Dessas, 56% apresentaram resultados inconsistentes com o estudo original. Duas práticas inicialmente consideradas seguras e eficazes foram posteriormente consideradas prejudiciais após uma reavaliação adequada: a ressuscitação volêmica com hidroxietilamido apresentou as evidências mais consistentes de danos. Em média, foram necessários 4.6 anos até que alguém sequer tentasse verificar esses resultados.
Revisões sistemáticas, 2016. A própria busca, muitas vezes, não era reproduzível. Uma revisão de 272 revisões sistemáticas em 25 periódicos constatou que apenas 13% relataram uma estratégia de busca detalhada o suficiente para ser reproduzida em todos os bancos de dados utilizados. Os termos de busca foram relatados em 91% dos casos, mas o banco de dados utilizado e o momento em que a busca foi efetivamente realizada geralmente não eram informados.
E não se trata apenas de recuperação de dados: o que é relatado pode divergir do que foi pré-especificado. Uma revisão separada de registros de ensaios clínicos encontrou uma discrepância mediana de 31% entre os desfechos primários registrados e os publicados, chegando a 100% em alguns estudos, e uma discrepância mediana de 54% para os desfechos secundários. Quando os desfechos mudaram posteriormente, em cerca de metade dos casos, eles favoreceram um resultado estatisticamente significativo.
É por isso que tanto a indústria quanto a regulamentação estão caminhando para a recuperação de dados em nível de estudo, e não em nível de aplicativo. A EMA exige a publicação proativa de relatórios completos de estudos clínicos desde a entrada em vigor da sua Política 0070, em 2016, e não apenas de resultados resumidos. Editores de periódicos, por meio do ICMJE, exigem um plano de compartilhamento de dados para ensaios clínicos desde 2018. Plataformas sem fins lucrativos como a Vivli existem justamente para que um pesquisador possa solicitar dados completos de um estudo, e não documentos dispersos de múltiplos sistemas. Nada disso funciona se o "estudo" existir apenas como fragmentos de dados em aplicativos desconectados.
Os 5 requisitos essenciais para a recuperação de informações em nível de estudo:
- Um único ID persistente para todo o estudo.Não se trata de um ID por documento ou conjunto de dados, mas sim de um ID que vincule o protocolo, os dados do estudo, o código de análise e o relatório do estudo clínico (CSR) como uma única unidade recuperável.
- Um pacote completo, não apenas o conjunto de dados.A reanálise de um único ensaio clínico em 2026 serve como um alerta: os dados brutos, sem o protocolo, o dicionário e os métodos de análise, não são reutilizáveis. O Modelo de Dados de Resultados de Análise (ARDM) reforça essa ideia.
- Uma única consulta controlada em vez de cinco logins separados.Um pesquisador ou um órgão regulador precisa extrair um estudo inteiro de uma só vez, e não reconstruí-lo a partir do EDC, do eTMF e de um repositório de estatísticas.
- Metodologia documentada, até o número da semente.A reprodutibilidade exata nesse nível de detalhamento depende dos pormenores. Se não for capturada naquele momento, não poderá ser recuperada posteriormente.
- Estudos antigos e novos podem ser recuperados da mesma forma.A revisão do GLP-1 precisava de ensaios clínicos realizados desde meados da década de 2000 para serem agrupados com ensaios da década de 2020. Um sistema de recuperação que só funciona para estudos de anos anteriores não é um sistema de recuperação de fato: é apenas uma conveniência temporária.
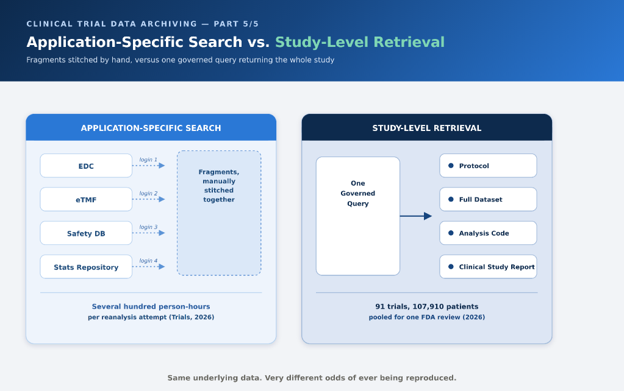
A revisão de segurança do GLP-1 é a versão positiva dessa história. Responder à pergunta “existe realmente um risco de suicídio?” exigiu tratar décadas de ensaios clínicos com Saxenda, conduzidos muito antes de essa questão sequer existir, como dados recuperáveis e agrupáveis, juntamente com os ensaios mais recentes com Wegovy e Zepbound. Isso só funciona se o registro completo de um ensaio clínico sobreviver como um pacote coerente e recuperável, e não como uma pasta de arquivos que por acaso sobreviveram no sistema em que foram criados. Graças a isso, a agência pôde agrupar 91 ensaios clínicos e resolver uma questão de segurança de grande repercussão com dados reais, em vez de palpites: o resultado foi a remoção de um alerta, e não o agravamento de uma bula.
Tudo nesta lista representa, na verdade, os princípios FAIR apresentados nesta série na Parte 3, aplicados ao nível do estudo em vez do registo individual:
- LocalizávelCada estudo possui um ID permanente, e não IDs de documentos dispersos em sistemas separados.
- AcessívelUm processo de recuperação controlado retorna o estudo completo mediante solicitação, e não uma busca manual em diversos sistemas.
- InteroperávelEstudos antigos e novos utilizam uma estrutura que permite que sejam incluídos na mesma análise conjunta sem a necessidade de um projeto de tradução.
- ReutilizávelO protocolo, o dicionário de dados, os métodos de análise e os resultados são compartilhados, de modo que a reanálise não depende da memorização de detalhes que ninguém anotou.
Ignore qualquer uma dessas etapas e a recuperação de dados em nível de estudo retorna silenciosamente à busca específica do aplicativo, que é tecnicamente possível, mas praticamente lenta e está a um link quebrado de gerar um resultado irreproduzível.
Este é o fim da série de posts no blog, então vale a pena destacar o tema central. Cada post abordou um problema diferente: justificativa de custos, relevância da IA, vantagem em fusões e aquisições, proliferação de aplicativos, resultado da recuperação de dados . Na verdade, todos eles respondiam à mesma pergunta, feita sob uma perspectiva diferente: seus dados são suficientemente bem governados para serem encontrados, considerados confiáveis e reutilizados por alguém que não estava presente quando foram criados?
- Dimensão 1 - Centro de Custo para Ativo EstratégicoDados de ensaios clínicos arquivados, quando bem reutilizados, podem reduzir os prazos de desenvolvimento.
- Dimensão 2 - Espelho retrovisor para dados de treinamentoEsse mesmo arquivo é a matéria-prima para modelos de IA, desde que sua proveniência seja documentada com o mesmo rigor que o próprio modelo.
- Dimensão 3 - Transformar o fardo arquivístico em uma vantagem unificadaFusões e aquisições multiplicam arquivos; os princípios FAIR são o que permitirão que os dados de duas empresas se tornem um recurso utilizável em vez de dois arquivos físicos.
- Dimensão 4 - Da integração de aplicações à interoperabilidade realAplicações de ponta podem coexistir com interoperabilidade real, mas somente se uma camada de dados comum e governada estiver subjacente a todas elas.
- Dimensão 5 — Busca específica da aplicação para recuperação em nível de estudoTudo isso só compensa se o estudo completo puder ser recuperado, de forma integral e reproduzível, quando necessário.
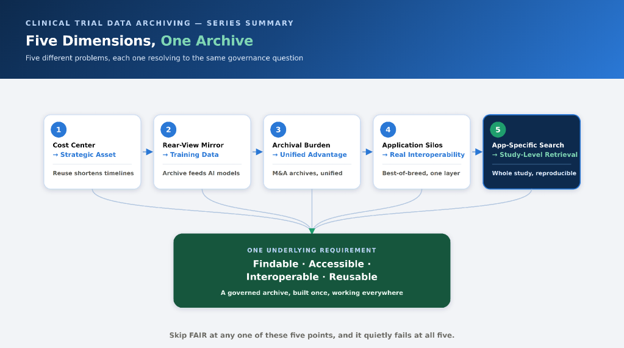
Cinco problemas distintos, um requisito fundamental: dados que sejam localizáveis, acessíveis, interoperáveis e reutilizáveis — para IA, para fusões e aquisições, para os aplicativos que os geram e para o momento em que alguém precisar reproduzir todo o estudo.
Nenhuma dessas cinco dimensões é opcional por si só, e nenhuma delas funciona isoladamente. Um arquivo que seja barato de criar e reutilizar, mas que não consiga alimentar um modelo de IA, unificar-se após uma aquisição, sobreviver a uma pilha de aplicativos de múltiplos fornecedores ou ser recuperado integralmente sob pressão regulatória, na verdade, não está pronto. O princípio FAIR nunca se concentrou em nenhum desses cinco problemas individualmente. Ele sempre abordou todos eles simultaneamente.
Se este for o tipo de problema para o qual sua organização também está aplicando IA em estágios iniciais do processo, vale a pena conferir o white paper do meu colega Rohit Pardeshi e Soumith Babburi : ele apresenta uma estrutura para usar infraestrutura de dados conectada para acelerar o reposicionamento de medicamentos e a identificação de alvos impulsionados por IA — a mesma lógica de "estudo completo, não apenas uma área" defendida neste blog, aplicada à decisão sobre o que pesquisar a seguir, em vez de como defender o que já foi estudado. Uma Estrutura para o Reposicionamento de Medicamentos e a Identificação de Alvos Impulsionados por IA em P&D Farmacêutica.
Se você trabalha em bioestatística, assuntos regulatórios ou gerenciamento de dados: se um órgão regulador pedisse à sua organização amanhã para reunir todos os ensaios clínicos de um produto dos últimos quinze anos, você recuperaria o estudo inteiro ou o reconstruiria, uma aplicação por vez?
Perguntas Frequentes
O que é a recuperação de dados em nível de estudo na gestão de dados de ensaios clínicos?
A recuperação em nível de estudo significa recuperar um estudo clínico completo como um pacote único, controlado e confiável, em vez de procurar registros individuais em aplicativos separados. Ela conecta o protocolo, os dados do estudo, os métodos de análise e o relatório do estudo clínico, permitindo que o estudo seja recuperado e reutilizado como um todo.
Qual a diferença entre busca específica de aplicação e recuperação em nível de estudo?
A busca específica da aplicação recupera informações de um sistema por vez, como um EDC, um eTMF ou um banco de dados de segurança. A recuperação em nível de estudo fornece o estudo completo por meio de uma única solicitação controlada, reduzindo a necessidade de reconstruir manualmente informações de vários sistemas desconectados.
Por que a recuperação de dados em nível de estudo é importante para ensaios clínicos?
A recuperação de dados em nível de estudo facilita a localização, o acesso, a análise, a reprodução e a reutilização de dados de ensaios clínicos. Reter apenas os dados não é suficiente; o protocolo associado, o dicionário de dados, a metodologia e os resultados também devem permanecer recuperáveis e conectados.
O que deve ser incluído em um pacote completo de dados de um ensaio clínico?
Um pacote completo de ensaio clínico deve incluir o protocolo do estudo, os dados do estudo, o dicionário de dados, o código ou métodos de análise e o relatório do estudo clínico. Esses componentes fornecem o contexto necessário para compreender, reproduzir e reutilizar o estudo, em vez de depender apenas dos dados brutos.
O que é o Modelo de Dados de Resultados de Análise (ARDM)?
O Modelo de Dados de Resultados de Análise (ARDM) trata os resultados da análise, como tabelas, estatísticas e figuras, como dados estruturados, legíveis por máquina e reutilizáveis, em vez de documentos estáticos. Essa abordagem ajuda a tornar os resultados da análise recuperáveis para uso futuro sem a necessidade de recalculá-los do zero.
Como a recuperação de dados em nível de estudo contribui para a reprodutibilidade de ensaios clínicos?
A recuperação de informações em nível de estudo favorece a reprodutibilidade, mantendo reunidas as informações necessárias para reproduzir um estudo. Isso inclui o protocolo, o dicionário de dados, os métodos de análise e outros detalhes metodológicos, incluindo informações exatas, como números de sementes estatísticas, quando necessário.
Quais são os cinco requisitos essenciais para a recuperação de informações em nível de estudo?
Os cinco requisitos essenciais são: um único ID persistente para todo o estudo, um pacote de estudo completo, uma consulta única e controlada em vez de múltiplas buscas em aplicativos, metodologia documentada e recuperação consistente de estudos, tanto antigos quanto novos.
Como os princípios FAIR se aplicam à recuperação de dados de ensaios clínicos?
Os princípios FAIR tornam os dados de ensaios clínicos Localizáveis, Acessíveis, Interoperáveis e Reutilizáveis. No nível do estudo, isso significa usar identificadores de estudo persistentes, recuperação controlada, estruturas compatíveis e manter o protocolo, os dados, os métodos e os resultados juntos.
Como a recuperação de dados em nível de estudo auxilia a revisão regulatória e a análise de segurança?
A recuperação de dados em nível de estudo permite que pesquisadores e órgãos reguladores acessem e reúnam dados completos de ensaios clínicos ao investigar questões importantes de segurança ou regulamentação. A revisão de segurança do GLP-1 ilustra como ensaios históricos podem ser recuperados e combinados com estudos mais recentes para responder a uma questão específica de segurança.
Por que os ensaios clínicos antigos deveriam ser recuperáveis usando a mesma abordagem que os novos ensaios?
Estudos históricos podem precisar ser combinados com estudos mais recentes para revisões regulatórias, análises de segurança ou pesquisas. Portanto, um sistema de recuperação de dados deve tornar tanto estudos antigos quanto novos acessíveis por meio da mesma abordagem padronizada, em vez de limitar a recuperação a dados criados recentemente.
Referências
- FDA dos EUA, “FDA solicita a remoção do alerta sobre comportamento e ideação suicida de medicamentos GLP-1 RA” (abril de 2026) — fda.gov/drugs/drug-safety-communications/fda-requests-removal-suicidal-behavior-and-ideation-warning-glucagon-peptide-1-receptor-agonist-glp
- Notícias científicas, “Pesquisa irreprodutível em ciências da vida nos EUA custa US$ 28 bilhões”, reportagem sobre Freedman, Cockburn e Simcoe, “A economia da reprodutibilidade na pesquisa pré-clínica”, PLOS Biology (2015) — sciencenews.org/article/irreproducible-life-sciences-research-us-costs-28-billion
- Kirchner et al., “Repensando os dados de estudos clínicos: por que devemos respeitar os resultados das análises como dados”, Scientific Data (2022) — nature.com/articles/s41597-022-01789-2
- Ansari et al., “A reprodutibilidade das estratégias de busca é baixa em revisões sistemáticas publicadas em periódicos de alto impacto nas áreas de pediatria, cardiologia e cirurgia”, PLOS One (2016) — journals.plos.org/plosone/article?id=10.1371/journal.pone.0163309
- Ensaios clínicos (Springer Nature), “Apoio à reanálise e reutilização de dados de ensaios clínicos: um estudo de caso” (2026) — link.springer.com/article/10.1186/s13063-026-09646-y
- Niven et al., “Reprodutibilidade da pesquisa clínica em cuidados intensivos: uma revisão de escopo”, BMC Medicine (2018) — link.springer.com/article/10.1186/s12916-018-1018-6
- Franklin et al., “Viabilidade do uso de dados do mundo real para replicar evidências de ensaios clínicos”, JAMA Network Open (2020) — jamanetwork.com/journals/jamanetworkopen/fullarticle/2752575
- Jones et al., “Comparação de resultados registrados e publicados em ensaios clínicos randomizados: uma revisão sistemática”, BMC Medicine (2015) — link.springer.com/article/10.1186/s12916-015-0520-3
- New England Journal of Medicine, “Transparência e a Agência Europeia de Medicamentos — Partilha de Dados de Ensaios Clínicos” (2015) — nejm.org/doi/full/10.1056/NEJMp1409464
- Wilkinson et al., “Os Princípios Orientadores FAIR para a gestão e administração de dados científicos”, Scientific Data (2016) — nature.com/articles/sdata201618
- Vivli, plataforma global sem fins lucrativos para compartilhamento de dados de pesquisa clínica — vivli.org
#EnsaiosClínicos #GestãoDeDadosClínicos #CiênciasDaVida #Reprodutibilidade #DadosFAIR #EstratégiaDeDados #DesenvolvimentoDeMedicamentos #AssuntosRegulatórios

Murali Krishnam
Vice-presidente de Estratégia de Produto, IA Empresarial para o Setor Farmacêutico
AVISO LEGAL: O CONTEÚDO, AS VISÕES E AS OPINIÕES EXPRESSAS NESTE BLOG SÃO EXCLUSIVAMENTE DO(S) AUTOR(ES) E NÃO REFLETEM A POLÍTICA OU POSIÇÃO OFICIAL DA SOLIX TECHNOLOGIES, INC., SUAS AFILIADAS OU PARCEIROS. ESTE BLOG É OPERADO DE FORMA INDEPENDENTE E NÃO É REVISADO OU ENDOSSADO PELA SOLIX TECHNOLOGIES, INC. EM SUA CAPACIDADE OFICIAL. TODAS AS MARCAS REGISTRADAS, LOGOTIPOS E MATERIAIS PROTEGIDOS POR DIREITOS AUTORAIS DE TERCEIROS AQUI REFERIDOS SÃO PROPRIEDADE DE SEUS RESPECTIVOS PROPRIETÁRIOS. QUALQUER USO É ESTRITAMENTE PARA FINS DE IDENTIFICAÇÃO, COMENTÁRIOS OU EDUCACIONAIS, DE ACORDO COM A DOUTRINA DO USO JUSTO (LEI DE DIREITOS AUTORAIS DOS EUA, § 107 E EQUIVALENTES INTERNACIONAIS). NÃO HÁ NENHUM PATROCÍNIO, ENDOSSO OU AFILIAÇÃO IMPLÍCITA COM A SOLIX TECHNOLOGIES, INC. O CONTEÚDO É FORNECIDO "NO ESTADO EM QUE SE ENCONTRA", SEM GARANTIAS DE PRECISÃO, INTEGRIDADE OU ADEQUAÇÃO A QUALQUER FIM. A SOLIX TECHNOLOGIES, INC. SE ISENTA DE TODA RESPONSABILIDADE POR AÇÕES TOMADAS COM BASE NESTE MATERIAL. OS LEITORES ASSUMEM TOTAL RESPONSABILIDADE PELO USO DESTAS INFORMAÇÕES. A SOLIX RESPEITA OS DIREITOS DE PROPRIEDADE INTELECTUAL. PARA ENVIAR UMA SOLICITAÇÃO DE REMOÇÃO DMCA, ENVIE UM E-MAIL PARA INFO@SOLIX.COM COM: (1) IDENTIFICAÇÃO DA OBRA, (2) URL DO MATERIAL INFRATOR, (3) SEUS DADOS DE CONTATO E (4) UMA DECLARAÇÃO DE BOA-FÉ. REIVINDICAÇÕES VÁLIDAS RECEBERÃO ATENÇÃO IMEDIATA. AO ACESSAR ESTE BLOG, VOCÊ CONCORDA COM ESTA ISENÇÃO DE RESPONSABILIDADE E COM NOSSOS TERMOS DE USO. ESTE CONTRATO É REGIDO PELAS LEIS DA CALIFÓRNIA.
-
 White Paper
Arquitetura de Informação Empresarial para IA Gen e Aprendizado de Máquina
Baixar o White Paper -
-
-