A conversa que a maioria dos programas de IA não está tendo.
As organizações que passam de projetos-piloto de IA para programas de IA compartilham um padrão: elas resolveram a questão da arquitetura antes que a escala a revelasse. Elas definiram como a base de dados precisava ser estruturada – em termos de propriedades de armazenamento, camadas semânticas e controles de pipeline – antes da implantação do segundo ou terceiro aplicativo de produção.
A maioria não segue essa sequência. O modelo é escolhido. Os casos de uso são definidos. Provas de conceito são construídas. E a base de dados é tratada como algo que será abordado à medida que o programa crescer. Em ambientes corporativos, essa suposição é invariavelmente a origem do atraso – e do custo – quando a escalabilidade é finalmente tentada.
Acessível não é o mesmo que preparado para IA.
A distinção que tende a ser ignorada no planejamento inicial de programas de IA é entre dados acessíveis e dados prontos para IA.
Os dados acessíveis podem ser consultados . Eles existem em um sistema, podem ser extraídos e um modelo pode ser direcionado a eles. A maioria dos dados corporativos atende a esse critério. Os dados prontos para IA são governados desde o ponto de ingestão, carregam significado semântico verificado, tiveram sua qualidade validada antes de chegar a um modelo e podem ser rastreados da origem à resposta sem lacunas na linhagem.
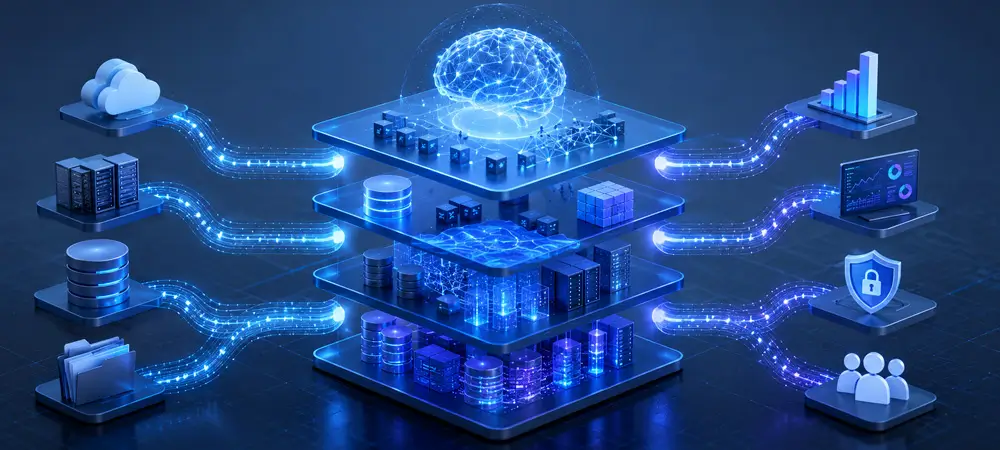
A diferença entre essas duas definições é de ordem arquitetônica, não um problema de projeto de qualidade de dados. Não é possível governar dados retroativamente na escala exigida pela IA empresarial. As três camadas que determinam a escalabilidade da IA empresarial — armazenamento, metadados e pipelines — têm funções distintas e criam as condições necessárias para a camada seguinte.
Por que a fundação é sempre a última coisa a ser construída?
A maioria dos ambientes de dados corporativos não foi projetada com IA em mente. Os dados são armazenados em sistemas criados para processamento de transações. Os metadados — quando existem — estão documentados em planilhas, ocultos em dicionários de dados ou guardados na memória dos engenheiros que construíram os sistemas originais. Os pipelines são construções pontuais, nunca projetadas para alimentar uma aplicação de IA em produção em escala.
O resultado: toda iniciativa de IA começa efetivamente do zero na camada de dados. As verificações de qualidade são aplicadas de forma inconsistente. A governança é adicionada posteriormente. As plataformas genéricas de aprendizado de máquina fornecem ferramentas para o desenvolvimento de modelos, mas não a ingestão governada, a camada semântica ou os controles de qualidade de nível de produção que tornam essas ferramentas confiáveis em dados empresariais reais. Os clientes constroem essas camadas por conta própria – e é por isso que as iniciativas de IA invariavelmente levam mais tempo e custam mais do que o previsto inicialmente.
Três camadas, três funções distintas
A camada de armazenamento é onde a governança começa ou é permanentemente adiada. Transações ACID , evolução de esquemas e consultas de viagem no tempo não são recursos de desempenho – são requisitos de governança. A evolução de esquemas é importante porque os sistemas de origem corporativos mudam continuamente; uma camada de armazenamento que não consegue absorver essas mudanças torna-se um gargalo para todas as iniciativas de IA acima dela. Consultas de viagem no tempo permitem que empresas regulamentadas respondam a perguntas de auditoria históricas sem a necessidade de reconstrução manual de dados. A retenção imposta na ingestão elimina toda uma classe de risco de conformidade que a maioria das organizações atualmente gerencia por meio de processos e documentação, em vez de arquitetura. O Solix oferece isso por meio de um lakehouse governado baseado em Apache Hudi e uma Zona de Preservação dedicada para dados de aplicativos corporativos, com capacidade de retenção e bloqueio legal ativa desde o momento em que os dados chegam.
A camada de metadados é onde os dados adquirem significado – e onde a maioria das bases de IA empresarial são mais frágeis. Um esquema de banco de dados informa quais campos existem, não o que eles representam ou como se relacionam entre os aplicativos. Um sistema de IA que raciocina sobre um esquema bruto infere um significado de negócio que não possui, produzindo resultados que não podem ser explicados ou rastreados até uma origem. Um Grafo de Conhecimento de Aplicativo preenche essa lacuna: uma camada semântica que codifica os objetos de negócio, relacionamentos, vocabulário e padrões de consulta testados específicos para um aplicativo empresarial. A Solix fornece Grafos de Conhecimento de Aplicativo pré-construídos para Oracle EBS , SAP ECC/S4HANA , PeopleSoft e JD Edwards – eliminando a camada mais trabalhosa da construção semântica para o cliente. Para conteúdo não estruturado, um índice semântico construído na ingestão aplica o mesmo princípio: o significado é codificado antes que um modelo raciocine sobre ele. O resultado são respostas de IA que podem ser rastreadas até uma definição de negócio certificada e apresentadas a um órgão regulador ou conselho com confiança.
A camada de pipeline é onde se determina a confiabilidade de cada resultado de IA subsequente. O perfilamento automatizado, as regras de qualidade, o rastreamento de linhagem e os fluxos de trabalho de preparação de dados garantem que os problemas sejam detectados na ingestão — e não depois que uma recomendação de IA falha já tenha influenciado uma decisão de negócios. O Solix estrutura isso em quatro etapas sequenciais governadas — ingestão, lakehouse governado, qualidade de dados e fluxo de ML — cada uma auditável, reduzindo o tempo entre a chegada dos dados e sua prontidão para produção em IA.
Como é uma base pronta para produção?
Considere uma organização de serviços financeiros que consolida dados do Oracle EBS e do SAP, juntamente com feeds operacionais em tempo real e registros arquivados de aplicativos desativados. O objetivo: uma plataforma de inteligência operacional e de risco baseada em IA, com acesso em linguagem natural para usuários de negócios e uma base governada para equipes de ciência de dados.
Na camada de armazenamento, os dados chegam a um ambiente controlado (lakehouse) com transações ACID , evolução de esquema e consultas de histórico para fins de conformidade regulatória. Os dados de aplicações legadas são movidos para uma Zona de Preservação controlada – com retenção gerenciada e pronta para proteção legal desde a chegada.
Na camada de metadados, os Gráficos de Conhecimento de Aplicativos pré-construídos para Oracle EBS e SAP são configurados de acordo com a estrutura específica da organização, codificando os fluxos de valor de Compras a Pagamentos, de Pedidos a Recebimento e de Registro a Relatórios. Um Catálogo Unificado de Ativos mantém definições de negócios certificadas e a linhagem de dados em todo o ambiente. Quando um analista de negócios realiza uma consulta em linguagem natural ou um modelo de risco examina os dados, a resposta é rastreada até uma definição certificada – e não a partir de uma tabela bruta.
Na camada de pipeline, as regras de qualidade são acionadas antes que os dados cheguem a qualquer modelo. O rastreamento de linhagem monitora cada elemento, da origem ao produto pronto para IA. A equipe de ciência de dados trabalha com dados governados, e não com meses de engenharia de dados personalizada antes que o primeiro modelo possa ser treinado.
Três perguntas antes que a próxima iniciativa de IA seja ampliada
Antes de se comprometer com a próxima fase de investimento em IA, vale a pena fazer três perguntas diretamente à equipe sobre a arquitetura de dados.
Os dados chegam a um ambiente governado desde o primeiro byte – com validação de qualidade, políticas de retenção e trilhas de auditoria aplicadas na ingestão – ou a governança é aplicada posteriormente, quando um problema surge? Organizações que não conseguem responder à primeira pergunta correm o risco de não conformidade, que aumenta a cada aplicação de IA implantada sobre a plataforma.
Os sistemas de IA que operam com esses dados possuem uma camada semântica que codifica o significado comercial, ou estão raciocinando diretamente sobre esquemas brutos? Sem essa camada, os resultados da IA não podem ser rastreados, explicados ou defendidos de forma confiável.
Os fluxos de dados que alimentam os modelos de IA produzem produtos de dados governados e com linhagem rastreada, ou entradas brutas que cada nova iniciativa deve reestruturar de forma independente? Esta última opção significa pagar o custo da engenharia de dados repetidamente – uma vez por iniciativa, em vez de uma única vez para a fundação.
Se alguma dessas perguntas for mais difícil de responder do que deveria, é aí que começa a revisão da arquitetura – e onde se inicia o projeto para uma IA empresarial escalável.

Stephen Tallant
Vice-presidente de marketing de produtos
AVISO LEGAL: O CONTEÚDO, AS VISÕES E AS OPINIÕES EXPRESSAS NESTE BLOG SÃO EXCLUSIVAMENTE DO(S) AUTOR(ES) E NÃO REFLETEM A POLÍTICA OU POSIÇÃO OFICIAL DA SOLIX TECHNOLOGIES, INC., SUAS AFILIADAS OU PARCEIROS. ESTE BLOG É OPERADO DE FORMA INDEPENDENTE E NÃO É REVISADO OU ENDOSSADO PELA SOLIX TECHNOLOGIES, INC. EM SUA CAPACIDADE OFICIAL. TODAS AS MARCAS REGISTRADAS, LOGOTIPOS E MATERIAIS PROTEGIDOS POR DIREITOS AUTORAIS DE TERCEIROS AQUI REFERIDOS SÃO PROPRIEDADE DE SEUS RESPECTIVOS PROPRIETÁRIOS. QUALQUER USO É ESTRITAMENTE PARA FINS DE IDENTIFICAÇÃO, COMENTÁRIOS OU EDUCACIONAIS, DE ACORDO COM A DOUTRINA DO USO JUSTO (LEI DE DIREITOS AUTORAIS DOS EUA, § 107 E EQUIVALENTES INTERNACIONAIS). NÃO HÁ NENHUM PATROCÍNIO, ENDOSSO OU AFILIAÇÃO IMPLÍCITA COM A SOLIX TECHNOLOGIES, INC. O CONTEÚDO É FORNECIDO "NO ESTADO EM QUE SE ENCONTRA", SEM GARANTIAS DE PRECISÃO, INTEGRIDADE OU ADEQUAÇÃO A QUALQUER FIM. A SOLIX TECHNOLOGIES, INC. SE ISENTA DE TODA RESPONSABILIDADE POR AÇÕES TOMADAS COM BASE NESTE MATERIAL. OS LEITORES ASSUMEM TOTAL RESPONSABILIDADE PELO USO DESTAS INFORMAÇÕES. A SOLIX RESPEITA OS DIREITOS DE PROPRIEDADE INTELECTUAL. PARA ENVIAR UMA SOLICITAÇÃO DE REMOÇÃO DMCA, ENVIE UM E-MAIL PARA INFO@SOLIX.COM COM: (1) IDENTIFICAÇÃO DA OBRA, (2) URL DO MATERIAL INFRATOR, (3) SEUS DADOS DE CONTATO E (4) UMA DECLARAÇÃO DE BOA-FÉ. REIVINDICAÇÕES VÁLIDAS RECEBERÃO ATENÇÃO IMEDIATA. AO ACESSAR ESTE BLOG, VOCÊ CONCORDA COM ESTA ISENÇÃO DE RESPONSABILIDADE E COM NOSSOS TERMOS DE USO. ESTE CONTRATO É REGIDO PELAS LEIS DA CALIFÓRNIA.
-
 White Paper
Arquitetura de Informação Empresarial para IA Gen e Aprendizado de Máquina
Baixar o White Paper -
-
-